
Kurzfazit
Ein Modell für seltene Fehler braucht geeignete Trainingsbeispiele und einen unabhängigen Test. Werden künstliche Beispiele bereits vor der Datentrennung erzeugt, kann diese Unabhängigkeit verloren gehen. Ein neuer Preprint untersucht das Problem an Kundendaten.
Die offizielle Dokumentation der Softwarebibliothek imbalanced-learn beschreibt denselben grundsätzlichen Fehler. Für Qualitätspraktiker folgt daraus eine konkrete Kontrollfrage: Lassen sich für jedes künstliche Trainingsbeispiel die verwendeten Ausgangsdaten nachweisen, und gehören diese ausschließlich zum erlaubten Trainingsbestand? Eine hohe Trefferquote allein beantwortet diese Frage nicht.
FQI Takeaway
- Herkunft mitprüfen: Auch künstliche Beispiele dürfen keine Informationen aus dem späteren Testbestand übernehmen.
- Reihenfolge absichern: Erst die Daten trennen, dann die Ergänzung seltener Fälle ausschließlich innerhalb des Trainings durchführen.
- Betriebsnähe erhalten: Der abschließende Test braucht reale Fehlerhäufigkeiten; gezielte Belastungstests werden getrennt ausgewiesen.
Das Prinzip auf einen Blick
Künstliche Intelligenz, kurz KI, kann aus gekennzeichneten Beispielen lernen, welche Teile auffällig sind. Seltene Fehler sind dabei oft schwach vertreten. Das Verfahren SMOTE, ausgeschrieben Synthetic Minority Over-sampling Technique, ergänzt die seltene Klasse durch künstliche Zwischenwerte vorhandener Beispiele. Es erzeugt damit Trainingspunkte aus Beziehungen zwischen Ausgangsdaten.
Genau diese Beziehungen müssen innerhalb der Trainingsgrenze bleiben. Die Dokumentation von imbalanced-learn unterscheidet zwei Folgen einer Ergänzung vor der Datentrennung: Informationen späterer Testfälle können in die Modellerstellung gelangen, und der Test kann eine künstlich veränderte Klassenverteilung erhalten. Eine technisch getrennte Dateiliste genügt deshalb nicht als Unabhängigkeitsnachweis.
Begriffe kurz erklärt
- Datenleckage: Informationen beeinflussen die Modellerstellung, obwohl sie für die spätere unabhängige Prüfung zurückgehalten werden sollten.
- SMOTE: Ein Verfahren, das aus benachbarten Beispielen der selteneren Klasse zusätzliche Trainingspunkte bildet.
- Klassenverteilung: Verhältnis der Fallgruppen, etwa Gutteile und unterschiedliche Fehlerarten, in einem Datensatz.
Deep Dive
Soumyadeep Roy untersucht im Preprint einen verbreiteten Datensatz zur Kundenabwanderung. Verglichen werden unterschiedliche Reihenfolgen von Datentrennung, Skalierung und Ergänzung der seltenen Klasse. Zusätzlich betrachtet die Arbeit redundante Eingaben, die Verlässlichkeit vorhergesagter Wahrscheinlichkeiten und kostenabhängige Entscheidungsschwellen.
Sie stellt auch Autoren-Code bereit. Für diesen FQI-Transfer wird ausschließlich das nachvollziehbare Problem der Datentrennung verwendet; Kundenbindung und Fertigungsprüfung bleiben unterschiedliche Anwendungen.
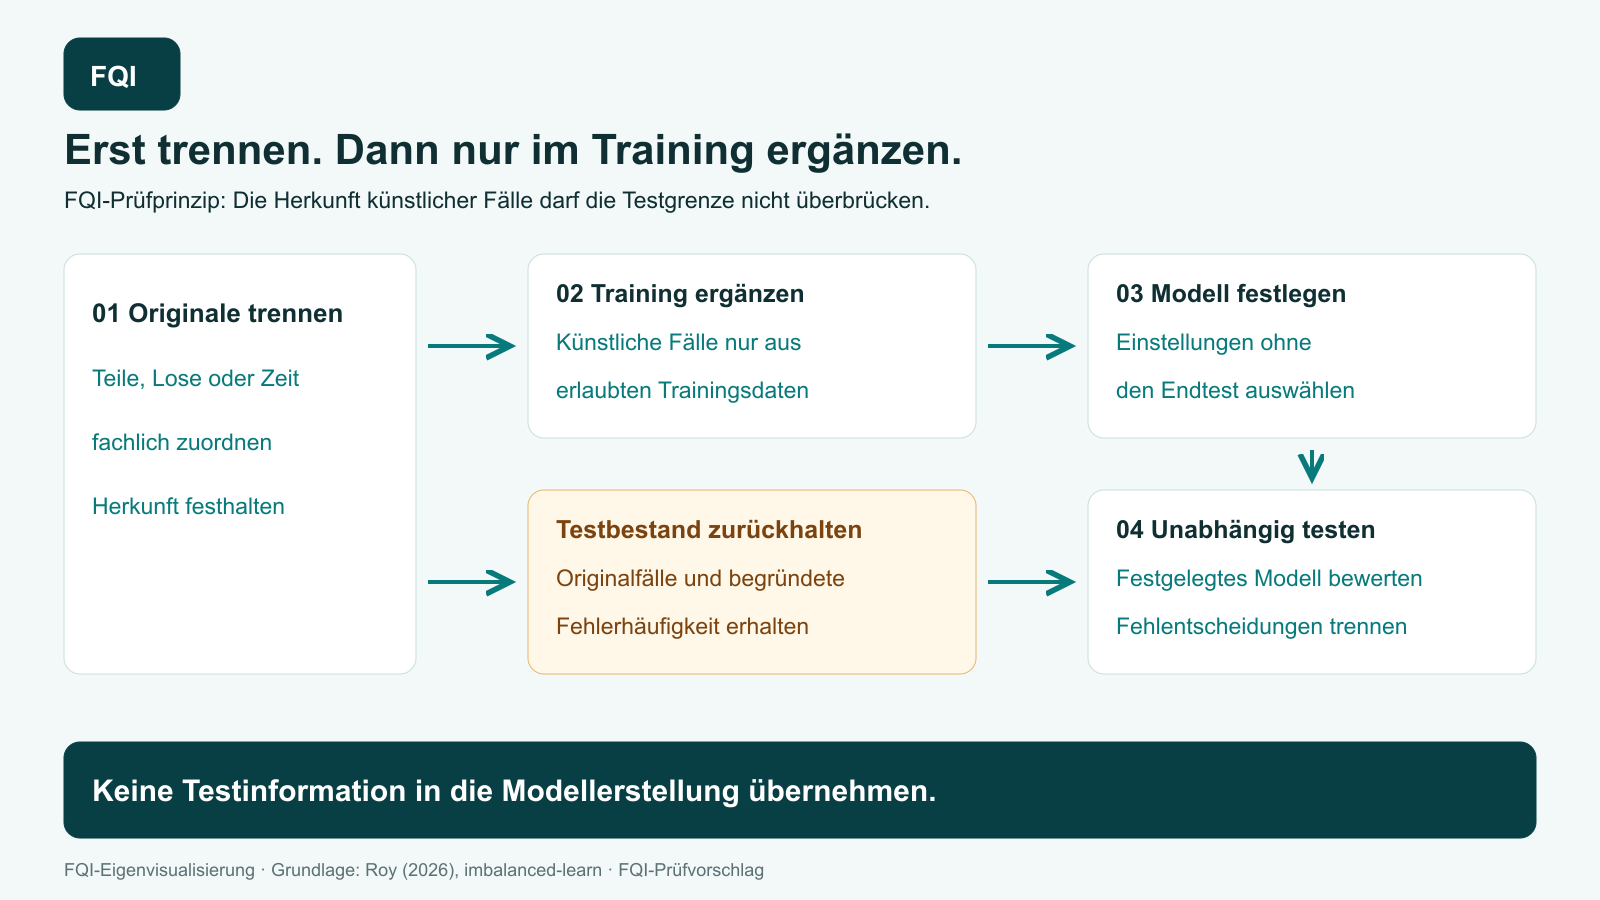
FQI schlägt dafür einen begrenzten Abnahmeversuch für ein Modell zur Teileprüfung vor. Zuerst legt das Team die Prüfungseinheit fest: Bauteil, Fertigungslos oder eine andere fachlich begründete Gruppe. Mehrere Aufnahmen desselben Teils dürfen die Trennung nicht unbemerkt überbrücken.
Ob zusätzlich nach Los, Anlage oder Zeit getrennt werden muss, hängt vom späteren Einsatz ab. Diese Entscheidung gehört in den Prüfplan.
Anschließend wird der unabhängige Testbestand festgeschrieben. Das Datenprotokoll dokumentiert Kennungen, Gruppenzuordnung und Zweck jedes Bestands. Bei einer künstlichen Ergänzung werden die Ausgangskennungen und die Verfahrensversion mitgeführt.
Die zentrale Kontrolle lautet: Kein künstlicher Trainingspunkt darf aus einem zurückgehaltenen Testfall abgeleitet sein. Fehlt die Herkunft, ist die Unabhängigkeit für diesen Stand nicht nachgewiesen.
Ein vereinfachtes FQI-Beispiel: Zwei ähnlich beschädigte Teile dienen als Ausgangspunkt für einen künstlichen Trainingsfall. Wird eines davon später als unabhängiger Testfall eingeordnet, sind die Dateien zwar verschieden, ihre Informationsherkunft aber verbunden. Der Prüfplan muss diese Verbindung erkennen. Der Fall ist eine Veranschaulichung, kein Versuchsergebnis des Preprints.
Auch die Auswahl von Einstellungen und Entscheidungsschwellen bleibt vom abschließenden Test getrennt. Für wiederholte interne Vergleiche wird die Datenaufbereitung jeweils nur aus dem zulässigen Trainingsanteil bestimmt. Nach der Auswahl läuft der festgeschriebene Endtest einmal nach dem vereinbarten Plan. FQI empfiehlt, unbeabsichtigte Wiederverwendung als Abweichung zu erfassen und die betroffenen Leistungsnachweise erneut zu prüfen.
Das Ergebnisprotokoll trennt übersehene Fehler, unnötige Rückweisungen und die zugrunde liegenden Fallzahlen. Ein zusätzlicher Test mit vielen seltenen Fehlern kann gezielt Belastungsgrenzen untersuchen. Er ersetzt aber nicht die Bewertung unter einer für den Einsatz begründeten Verteilung. Die Freigabe verbindet so Datenherkunft, Testbedingungen und akzeptierte Fehlentscheidungen.
Grenzen und Risiken
Der Preprint ist keine unabhängig bestätigte industrielle Validierung. Seine zusammengefasste Effektangabe und der separat ausgewiesene SMOTE-Vergleich beziehen sich auf unterschiedliche Aggregationen; eine einheitliche Prozentpunktzahl wird hier deshalb nicht übernommen. Der bereitgestellte Code wurde nicht ausgeführt.
Auch wirtschaftliche Einsparungen und allgemeine Empfehlungen zur Wahrscheinlichkeitskalibrierung werden nicht übertragen. Die unabhängige Softwaredokumentation stützt das Trennprinzip, bestätigt aber keine Kennzahl dieser Studie. Selbst korrekt getrennte Daten belegen noch keine ausreichende Abdeckung neuer Materialien, Anlagenzustände oder Fehlerarten.
FQI Fazit
Die Herkunft künstlicher Trainingsfälle gehört zum Nachweis eines belastbaren Modelltests. FQI empfiehlt dafür einen überprüfbaren Datenfluss vom Ausgangsfall bis zur Bewertung. Entscheidend sind eine fachlich begründete Trennung, nachvollziehbare Ableitungen und ein Testbestand, der seine vorgesehene Aussagekraft behält.
Ein sinnvoller nächster Schritt ist die Prüfung eines vorhandenen Modellprojekts auf genau diese Beziehungen. Werden Überschneidungen gefunden, braucht es einen neuen Leistungsnachweis; das bloße Entfernen doppelter Dateinamen genügt nicht.
Quellen & Transparenz
- Soumyadeep Roy: The Hidden Costs of 99% Accuracy, Preprint; Methoden, Ergebnistabellen und Grenzen im HTML-Volltext geprüft.
- imbalanced-learn: Common pitfalls and recommended practices, unabhängige technische Primärdokumentation zur Datentrennung.
- Autoren-Repository, Begleitmaterial zugänglich; keine unabhängige Reproduktion durchgeführt.
Prüfplan und Teilebeispiel sind eigenständige FQI-Ableitungen. KI-unterstützt erstellt. Am 3. Oktober 2026 durch Johann Fischer zur Veröffentlichung freigegeben. Der Feed meldet den Beitrag am 3. Oktober; die Originalseite nennt den 9. September 2026 als Einreichung. Der Datumswiderspruch bleibt offen.