
Kurzfazit
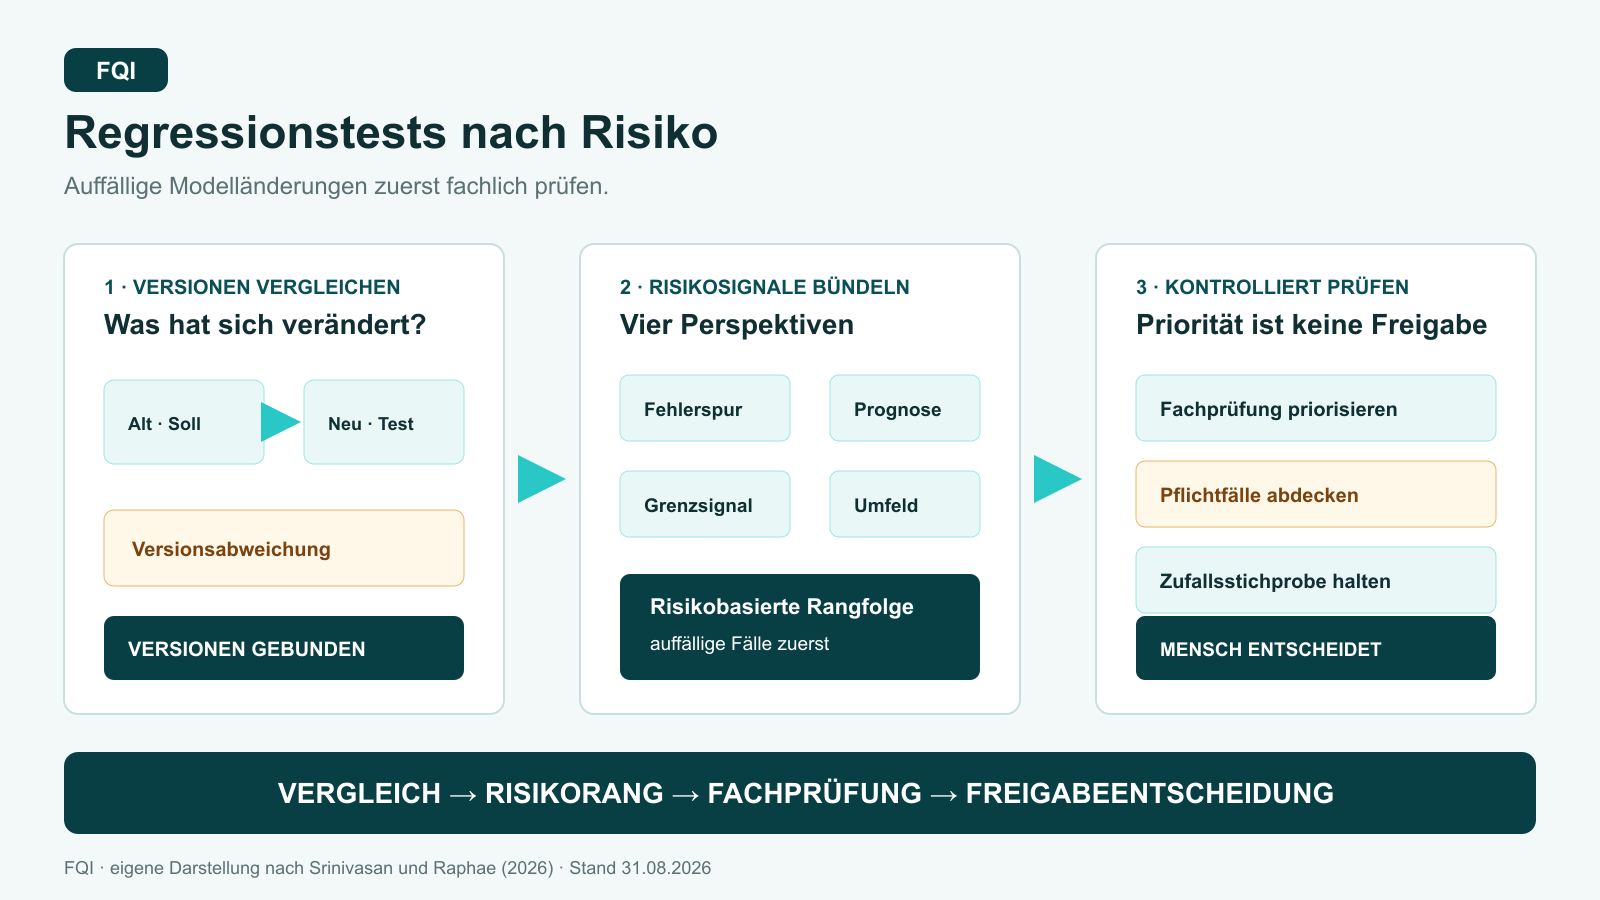
Nach einem Modellupdate sind oft mehr Testfälle vorhanden, als Menschen wirtschaftlich prüfen können. RiskBlend ordnet deshalb Fälle danach, wie stark sich Modellverhalten, Entscheidungsgrenze und lokale Datenumgebung zwischen zwei Versionen verändert haben. In vier öffentlichen Tabellendatensätzen lag das Verfahren bei der frühen Fehlerfindung durchgehend vor vier Vergleichsmethoden. Für FQI ist das kein Freigabeautomat, sondern ein risikobasierter Stichprobenplan: Er konzentriert teure Fachprüfung auf auffällige Änderungen, während Abdeckung, Akzeptanzkriterien und Freigabeverantwortung separat bestehen bleiben.
FQI Takeaway
- Versionen gemeinsam prüfen: Ein einzelner Konfidenzwert zeigt nicht, was sich durch das Update verändert hat.
- Fachprüfung nach Risiko staffeln: Fälle mit starken Grenz- oder Verhaltensverschiebungen werden zuerst gegen verlässliche Referenzen geprüft.
- Priorisierung nie mit Freigabe verwechseln: Ein guter Rangplatz ersetzt weder Mindestabdeckung noch unabhängige Akzeptanzentscheidung.
Das Prinzip auf einen Blick
Ein Regressionsfehler liegt hier vor, wenn die alte Modellversion einen Fall richtig und die neue ihn falsch klassifiziert. RiskBlend kombiniert vier Signale: Nähe zu bekannten Regressionsfehlern, Verschiebung der Vorhersage, Bewegung an der Entscheidungsgrenze und Veränderung der lokalen Nachbarschaft. Die Gewichte werden auf einem getrennten, bereits gelabelten Validierungsbestand gelernt. Die Rangfolge entsteht anschließend ohne Zugriff auf die Labels der zu prüfenden Fälle.
Das National Institute of Standards and Technology (NIST; US-Institut für Standards und Technologie) fordert für künstliche Intelligenz (KI) nachvollziehbare Tests, Evaluation, Verifikation und Validierung sowie dokumentierte Messgrößen und einsatznahe Prüfbedingungen. Eine risikobasierte Rangfolge kann diesen Prozess effizienter machen, aber nicht seine Anforderungen reduzieren.
Begriffe kurz erklärt
- Regressionstest: Prüfung, ob eine Änderung zuvor korrektes Verhalten verschlechtert hat.
- Entscheidungsgrenze: mathematische Trennlinie, an der ein Klassifikator von einer Klasse zur anderen wechselt.
- APFD: Average Percentage of Faults Detected; Kennzahl dafür, wie früh bekannte Fehler in einer sortierten Testfolge gefunden werden.
- TEVV: Test, Evaluation, Verification and Validation; strukturierter Nachweis für Anforderungen und Einsatzzweck.
- KI: Künstliche Intelligenz; Systeme, die aus Daten Muster ableiten oder Aufgaben automatisiert unterstützen.
- NIST: National Institute of Standards and Technology; US-Institut für Standards und Technologie.
Deep Dive
Die Autoren untersuchen vier Datensätze aus Finanz-, Sozial- und Gesundheitskontexten, fünf Klassifikatorfamilien und vier Arten von Modelländerungen. Dazu gehören neue Merkmale, zusätzliche leicht verschobene Trainingsdaten, stärkere kombinierte Änderungen und reine Änderungen der Vorverarbeitung. Jede Kombination wurde mit 15 Zufallsstarts wiederholt. Damit ergeben sich 1.200 experimentelle Konfigurationen und 80 Datensatz-Klassifikator-Szenario-Zellen.
Gemessen wurde die Average Percentage of Faults Detected (APFD; durchschnittlicher Anteil früh gefundener Fehler). RiskBlend erzielte in allen 80 Zellen den höchsten Mittelwert. Der Abstand zur jeweils stärksten Vergleichsmethode reichte von 0,003 bis 0,317 APFD; der Abstract fasst dies als Verbesserung von bis zu 0,32 zusammen. Besonders groß waren die Vorteile bei Entscheidungsbäumen und k-nächsten-Nachbarn. Eine Ablation, also das gezielte Entfernen einzelner Signale, zeigte: Die Verschiebung der Entscheidungsgrenze trug am meisten bei; das Nachbarschaftssignal brachte in diesen Versuchen kaum zusätzlichen Nutzen.
Für einen FQI-Pilot wird zuerst der Prüfzweck festgelegt. Das Team definiert kritische Fehlerarten, zugelassene Modell- und Datenversionen, Referenzlabels, Mindestabdeckung und das verfügbare Fachprüfvolumen. Danach werden alte und neue Version auf demselben ungesehenen Kandidatenbestand ausgeführt. Ein einfaches Baseline-Verfahren, etwa größte Vorhersageänderung zuerst, bleibt als Vergleich erhalten. RiskBlend oder ein vereinfachtes Mehrsignalmodell darf nur eingesetzt werden, wenn es in zurückgehaltenen Updates stabil mehr relevante Regressionsfehler innerhalb desselben Budgets findet.
Der Prüfplan dokumentiert Rangsignal, Gewichtungsstand, Validierungsbestand, Prüfquote und Reaktionsregel. Sicherheits- oder kundenspezifisch kritische Fälle können unabhängig vom Score verpflichtend sein. Zufallsstichproben aus niedriger priorisierten Fällen prüfen, ob die Rangfolge blinde Bereiche erzeugt. Bei neuen Merkmalen, anderer Vorverarbeitung, geändertem Klassifikator oder verschobener Population wird die Priorisierung selbst erneut validiert.
Grenzen und Risiken
Die Studie ist ein Preprint und verwendet ausschließlich tabellarische Binärklassifikation. Bilder, Texte, Mehrklassenprobleme und kontinuierliche Zielgrößen wurden nicht untersucht. Drei der vier Update-Szenarien enthalten synthetisch perturbierte Daten; reale Produktionsänderungen können anders aussehen. Die Gewichte hängen von einem repräsentativen gelabelten Validierungsbestand ab und werden schwächer, wenn dort kaum Regressionsfehler vorkommen. APFD bewertet die Reihenfolge bekannter Fehler, nicht ihre Schwere, Kosten oder Sicherheitswirkung. Nahezu perfekte Werte können zudem durch die jeweilige Fehlerdichte begünstigt sein. Ein Betriebseinsatz braucht deshalb Fehlergewichtung, Pflichtfälle und eine unabhängige Wirksamkeitsprüfung.
FQI Fazit
Begrenzte Prüfbudgets rechtfertigen keine blinde Stichprobe. RiskBlend zeigt, dass der direkte Vergleich zweier Modellversionen mehr Information liefert als die Unsicherheit der neuen Version allein. Qualitätspraktiker können daraus einen kontrollierten Ablauf ableiten: Änderungen sichtbar machen, auffällige Fälle zuerst prüfen, kritische Fälle verpflichtend abdecken und die Rangfolge mit Zufallsstichproben überwachen. So wird Testfallpriorisierung zum dokumentierten Prüfwerkzeug – nicht zum Ersatz für Referenzdaten, Risikobewertung oder menschliche Freigabe.
Quellen & Transparenz
- Srinivasan und Raphae: RiskBlend – A Multi-Signal Framework for Test Input Prioritization in Machine Learning Regression Testing, arXiv:2608.27704v1, eingereicht am 27. August 2026.
- National Institute of Standards and Technology (NIST): AI RMF Core – Measure. Der Transfer auf risikobasierte Prüfplanung, Prüfplan, Pflichtfälle und Freigaberegeln ist eine FQI-Einordnung.
- Evidenzstatus: evaluierter Preprint ohne Produktionsfeldstudie. Dieser Entwurf wurde KI-gestützt erstellt; menschliche Fach- und Quellenfreigabe liegen noch nicht vor.