
Kurzfazit
Beim Produktionsanlauf fehlen genau jene Daten, die eine zuverlässige KI-Prüfung benötigt: repräsentative Fehlerbilder. Ein aktueller Preprint erzeugt aus drei bis fünf Beispielen synthetische Defekte und überträgt sie auf neue Oberflächen. Im untersuchten Datensatz stieg die Erkennungsleistung deutlich. Für das Qualitätsmanagement entsteht damit eine Chance – aber auch eine neue Nachweispflicht für Realitätsnähe, Abdeckung und unerwünschte Artefakte.
FQI Takeaway
- Synthetische Daten können den Prüfhochlauf beschleunigen: Sie schließen vorübergehend die Datenlücke zwischen Produktionsstart und ausreichend vielen realen Fehlern.
- Generiert ist nicht automatisch repräsentativ: Morphologie, Häufigkeit, Lage, Beleuchtung und Prozessursache müssen gegen reale Bedingungen validiert werden.
- Freigabe braucht getrennte Datensätze: Generierte Bilder dürfen das Training unterstützen, aber nicht allein den unabhängigen Wirksamkeitsnachweis bilden.
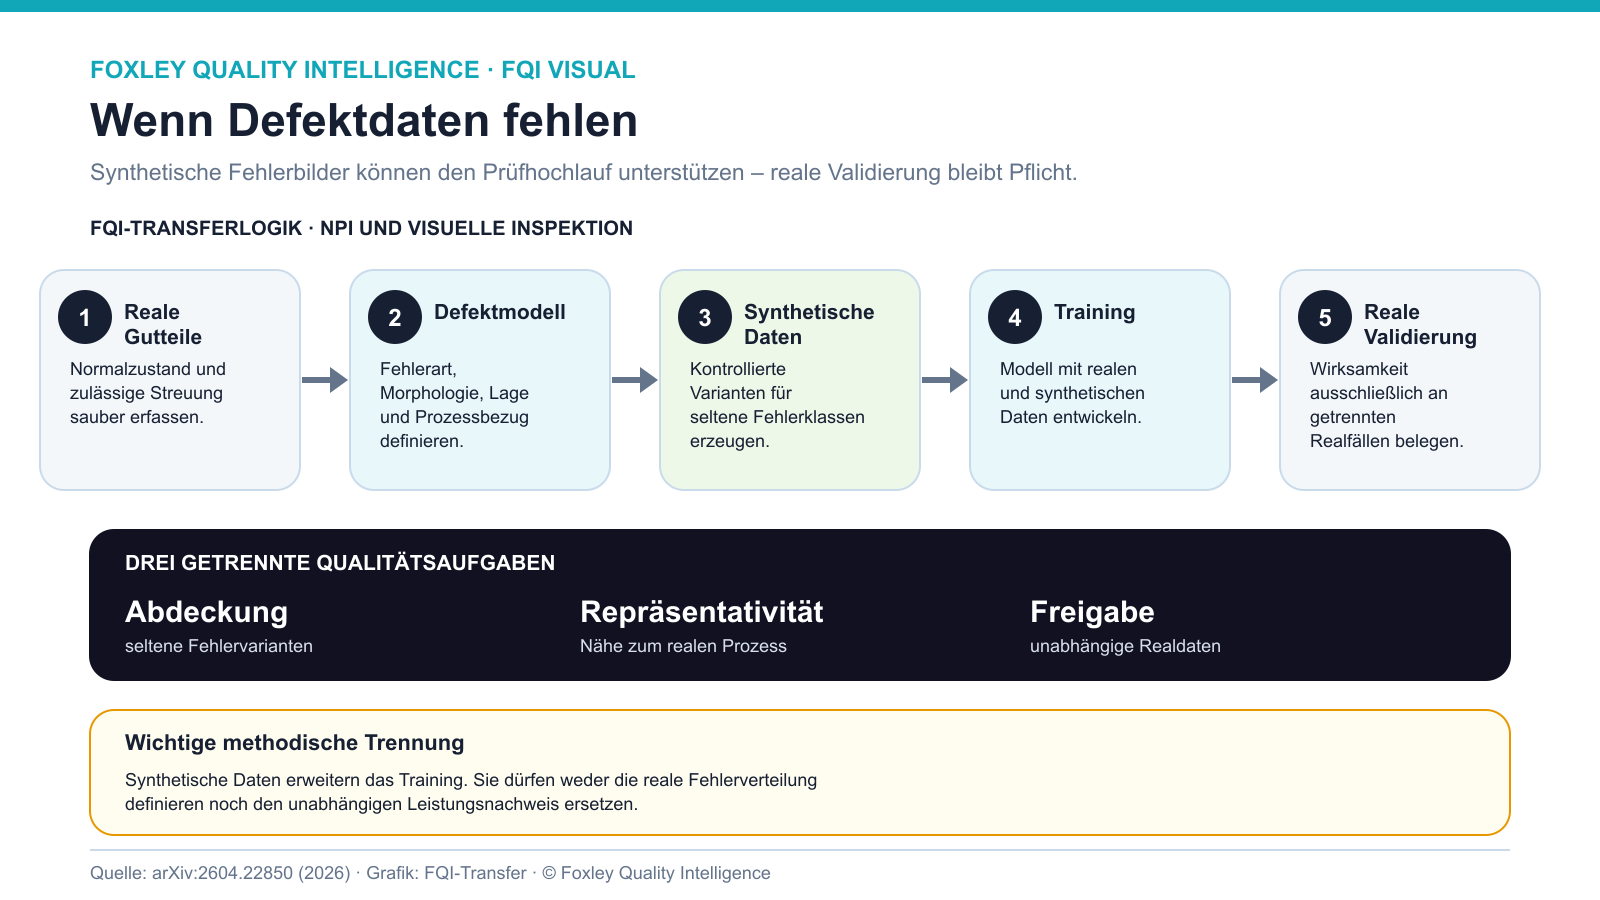
Das Prinzip auf einen Blick
Der Preprint „Accelerating New Product Introduction for Visual Quality Inspection via Few-Shot Diffusion-Based Defect Synthesis“ wurde im April 2026 veröffentlicht. Die Autoren lernen Fehlermerkmale aus wenigen annotierten Beispielen und übertragen sie per Diffusionsmodell auf fehlerfreie Zieloberflächen. Auf einem privaten industriellen Datensatz stieg die Mean Average Precision (mAP; mittlere durchschnittliche Präzision) im Few-Shot-Fall von 78,8 auf 83,3 Prozent und beim Zero-Shot-Domänentransfer von 65,0 auf 85,1 Prozent. Die Ergebnisse sind vielversprechend, aber noch nicht peer-reviewed und nur eingeschränkt extern prüfbar.
Begriffe kurz erklärt
- KI: Künstliche Intelligenz; Systeme, die aus Daten Muster ableiten oder Aufgaben automatisiert unterstützen.
- NPI: New Product Introduction; geregelter Prozess zur Einführung eines neuen Produkts in die Fertigung.
- FMEA: Fehlermöglichkeits- und Einflussanalyse; Methode zur vorbeugenden Bewertung von Risiken.
- DOE: Design of Experiments; statistische Versuchsplanung zur Ermittlung von Einflussgrößen und Wechselwirkungen.
Deep Dive
Visuelle Prüfmodelle benötigen Bilder, die relevante Streuung abbilden: unterschiedliche Fehlergrößen, Positionen, Materialien, Beleuchtungen, Kamerawinkel und Prozesszustände. Gerade bei einer Neuprodukteinführung (New Product Introduction, NPI) ist diese Datenbasis schwach. Kritische Fehler sind selten, neue Oberflächen noch nicht stabil eingefahren und Fehlerteile teilweise teuer oder sicherheitskritisch. Ein klassisch überwachtes Modell wird damit ausgerechnet dann unsicher, wenn die Prüfplanung schnell wirksam werden soll.
Die untersuchte Methode trennt das Erscheinungsbild eines Defekts möglichst weit vom ursprünglichen Hintergrund. Aus drei bis fünf morphologisch ähnlichen Beispielen wird eine kompakte Repräsentation gelernt. Anschließend setzt ein Diffusionsprozess den Defekt in eine definierte Region einer fehlerfreien Zieloberfläche ein. Eine Nachbearbeitung passt Farbe, Beleuchtung und lokale Gradienten an. Dadurch sollen Kratzer, Einstiche oder Falten nicht wie kopierte Fremdkörper wirken, sondern optisch in das neue Material eingebettet sein.
Für das Qualitätsmanagement liegt der Nutzen nicht nur in mehr Trainingsbildern. Synthetische Daten können Prüfplanung und FMEA (Fehlermöglichkeits- und Einflussanalyse) verbinden. Aus priorisierten Fehlerarten lassen sich gezielt Bildvarianten erzeugen: unterschiedliche Ausprägungen, Grenzfälle und Positionen. Damit wird aus dem FMEA-Risiko ein früher Prüfdatensatz. Besonders interessant ist der Zero-Shot-Transfer: Ein Fehlerkonzept aus einer bekannten Oberfläche wird auf ein neues Zielteil übertragen, obwohl dort noch kein reales Fehlerbeispiel vorliegt.
Der entscheidende Punkt ist jedoch die Validierungsarchitektur. Trainingsdaten, Parametrierungsdaten und unabhängige Testdaten müssen getrennt bleiben. Ein Modell darf nicht mit synthetischen Bildern trainiert und anschließend überwiegend mit Bildern desselben Generators bewertet werden. Sonst misst der Test vor allem, wie gut Detektor und Generator zueinander passen. Der belastbare Nachweis benötigt reale Teile, bewusst hergestellte Referenzfehler, Grenzmuster und später eintreffende Serienfehler.
Ein geeigneter Control Plan würde deshalb zusätzliche Merkmale enthalten: Anteil synthetischer Daten je Fehlerklasse, dokumentierte Generatorversion, Freigabe der Defektmorphologie durch Fachexperten, Übereinstimmung zwischen synthetischen und realen Merkmalsverteilungen sowie getrennte Kennzahlen für reale und künstliche Testdaten. Abweichungen zwischen beiden Gruppen sind ein Warnsignal für eine Simulations-Realitäts-Lücke.
Wirtschaftlich ist der Ansatz besonders dort interessant, wo reale Fehlerteile selten, teuer oder gefährlich sind. Der Nutzen muss aber gegen Erstellungs-, Prüf- und Pflegeaufwand gerechnet werden. Eine große Menge leicht erzeugbarer Bilder ist wertlos, wenn sie falsche Merkmale verstärkt oder die tatsächliche Prozessstreuung unterschätzt.
Für einen Pilotversuch empfiehlt sich ein begrenztes Design of Experiments (DOE; statistische Versuchsplanung). Eine Fehlerklasse wird in drei Datensätzen verglichen: nur reale Bilder, reale plus synthetische Bilder und eine Kontrollvariante mit klassischer Bildaugmentation. Bewertet wird ausschließlich auf zurückgehaltenen realen Teilen. Neben Erkennungsleistung sollten Fehlalarmquote, Robustheit gegen Beleuchtung sowie Leistung an Grenzmustern erfasst werden. So wird sichtbar, ob die Generierung tatsächlich zusätzliche Information liefert oder lediglich die Datenmenge vergrößert.
Grenzen und Risiken
Erstens handelt es sich um einen Preprint mit einem privaten industriellen Datensatz. Die berichteten Verbesserungen lassen sich deshalb nicht vollständig unabhängig reproduzieren.
Zweitens belegt optische Plausibilität keine physikalische Entstehungswahrscheinlichkeit. Ein visuell realistischer Fehler kann im realen Prozess unmöglich sein oder typische Kopplungen zu weiteren Merkmalen ignorieren.
Drittens können Generatorartefakte als ungewollte Abkürzung dienen. Das Prüfmodell lernt dann nicht den Defekt, sondern wiederkehrende Spuren des Generierungsverfahrens.
Viertens bleibt die seltene, aber kritische unbekannte Fehlerart offen. Synthetische Daten erweitern bekannte Fehlerklassen; sie garantieren keine Erkennung völlig neuer Mechanismen.
FQI Fazit
Synthetische Defektdaten sind kein Ersatz für reale Prüfevidenz, aber ein wirkungsvolles Anlaufwerkzeug. Richtig eingesetzt verkürzen sie die Zeit bis zu einem nutzbaren Prüfmodell und übersetzen priorisierte FMEA-Risiken in konkrete Trainingsfälle. Qualitätsfähig wird der Ansatz erst durch Datenherkunft, Versionslenkung, getrennte Testdaten und eine fortlaufende Rückkopplung mit realen Serienfehlern.
Quellen & Transparenz
- Jindal et al.: Accelerating New Product Introduction for Visual Quality Inspection via Few-Shot Diffusion-Based Defect Synthesis, arXiv:2604.22850, April 2026.
- Evidenzstatus: Preprint ohne abgeschlossene Peer-Review; Ergebnisse auf einem privaten industriellen Datensatz.
- FQI-Transfer: Die Verknüpfung mit FMEA, Control Plan, Datentrennung und Produktionsfreigabe ist eine fachliche Ableitung von FQI.
- Die genannten mAP-Werte beschreiben die untersuchten Versuchsbedingungen und sind keine allgemeine Leistungszusage.
- Bild: FQI-Fachinfografik, deterministisch erstellt; keine Darstellung eines konkreten Prüfaufbaus.
- Dieser Beitrag und die FQI-Eigenvisualisierung wurden KI-unterstützt erstellt, fachlich geprüft und am 10. August 2026 ausdrücklich zur Veröffentlichung freigegeben.
- Freigabestatus: Begriffserklärungen und Glossar wurden am 17. August 2026 erneut menschlich geprüft und zur Veröffentlichung freigegeben. Freigabe: Johann Fischer.