
Kurzfazit
AssertMate ist ein aktueller Forschungsansatz zur automatischen Erzeugung von Software-Prüfaussagen (Testassertions). Das System trennt die Frage, was beobachtet werden soll, von der Vorhersage des erwarteten Ergebnisses und kombiniert mehrere KI-Perspektiven. Für das Qualitätsmanagement ist der Transfer grundlegend: Prüfumfang allein belegt keine Wirksamkeit. Ein Test erkennt Fehler nur, wenn Prüfmerkmal, Referenz und Annahmekriterium fachlich korrekt definiert sind.
FQI Takeaway
- Codeabdeckung (Coverage) ist kein Wirksamkeitsnachweis: Ein ausgeführter Test ohne geeignetes Testorakel kann reale Fehler unentdeckt lassen.
- Prüfmerkmal und Sollwert müssen getrennt entwickelt werden: „Was messen?“ und „welches Ergebnis ist richtig?“ sind unterschiedliche Qualitätsfragen.
- KI braucht deterministische Gegenprüfungen: Statische Analyse, Ausführung und Mutationstests (Mutation Testing) sind belastbarer als reine Selbstbewertung durch Sprachmodelle.
Das Prinzip auf einen Blick
Der Preprint „Agent-Based Test Assertion Generation via Diverse Perspective Aggregation“ wurde am 6. August 2026 veröffentlicht. AssertMate kombiniert drei Komponenten: statische und typbasierte Konstruktion des beobachteten Istwerts, mehrere KI-Strategien zur Ermittlung des erwarteten Werts sowie einen LLM-basierten Auswahlagenten. LLM steht für Large Language Model, also großes Sprachmodell. Auf dem Defects4J-Benchmark wurden unter anderem Kompilierbarkeit, Bestehensrate und Fehlerentdeckungsrate bewertet. Die Arbeit ist noch nicht peer-reviewed und fokussiert auf Softwaretests in Java.
Begriffe kurz erklärt
- KI: Künstliche Intelligenz; Systeme, die aus Daten Muster ableiten oder Aufgaben automatisiert unterstützen.
- LLM: Large Language Model; großes Sprachmodell zur Verarbeitung und Erzeugung von Text.
- RAG: Retrieval-Augmented Generation; Sprachmodellerzeugung mit gezielt abgerufenen Quellen.
- FMEA: Fehlermöglichkeits- und Einflussanalyse; Methode zur vorbeugenden Bewertung von Risiken.
Deep Dive
Ein Modultest (Unit Test) besteht nicht nur aus Code, der eine Funktion ausführt. Er benötigt ein Testorakel: eine Aussage darüber, welches Ergebnis erwartet wird und wann der Test als bestanden gilt. Ohne belastbare Prüfaussage (Assertion) kann ein Test große Teile des Codes ausführen und trotzdem keinen Fehler erkennen. Diese Unterscheidung ist für das allgemeine Qualitätsmanagement hoch relevant. Auch ein physischer Prüfplan ist wirkungslos, wenn zwar Merkmale gemessen werden, aber Grenzwerte, Referenzen oder Reaktionsregeln ungeeignet sind.
AssertMate strukturiert die Aufgabe in drei Schritte. Zunächst wird mittels statischer Analyse und typabhängigen Regeln bestimmt, welcher Istwert sinnvoll beobachtet werden kann. Danach erzeugen mehrere Agenten aus unterschiedlichen Perspektiven Kandidaten für den erwarteten Wert – unter anderem über Codegenerierung, RAG (Retrieval-Augmented Generation; abrufgestützte Generierung) und mehrschrittiges Schlussfolgern. Ein weiterer Agent wählt eine Assertion aus. Diese Architektur reduziert die Aufgabe für das Sprachmodell: Es muss nicht gleichzeitig Prüfmerkmal, Messzugriff und Sollverhalten frei erfinden.
Im Defects4J-Versuch erreichte AssertMate nach Angaben der Autoren eine Kompiliererfolgsrate von 76,78 Prozent, eine Bestehensrate von 60,09 Prozent und eine Fehlerentdeckungsrate von 46,25 Prozent. Die Autoren berichten statistisch signifikante Verbesserungen gegenüber den untersuchten Vergleichsansätzen und ergänzten die Bewertung um Mutationstests. Gleichzeitig verursachte AssertMate einen deutlich höheren Tokenaufwand. Die Zahlen zeigen ein Potenzial, aber auch, dass ein erheblicher Anteil erzeugter Assertions weiterhin nicht kompiliert, nicht besteht oder Fehler nicht erkennt.
Der Transfer auf die Prüfplanung beginnt mit der Trennung von Prüfobjekt, Prüfmerkmal und Akzeptanzkriterium. Ein KI-System kann beispielsweise viele mögliche Prüfschritte aus einer Spezifikation erzeugen. Das allein erhöht noch nicht die Prüfwirksamkeit. Entscheidend ist, ob jeder Schritt einen relevanten Fehlermodus adressiert, mit einem geeigneten Prüfmittel durchgeführt wird und ein fachlich korrektes Sollkriterium besitzt. Die FMEA (Fehlermöglichkeits- und Einflussanalyse) kann dafür den Risikobezug liefern; die Test- oder Prüfplanung übersetzt ihn in Nachweise.
Mutationstests sind ebenfalls übertragbar. In der Software werden kontrollierte Fehler in den Code eingebracht, um zu prüfen, ob Tests sie erkennen. In technischen Prüfprozessen entspricht dies Grenzmustern, gezielten Fehlereinprägungen oder präparierten Fehlerteilen (Challenge Parts). Ein Prüfsystem sollte nicht nur bekannte Gutteile korrekt akzeptieren, sondern definierte Fehler sicher entdecken. Damit wird nicht der Prüfplanumfang, sondern die Entdeckungswirksamkeit bewertet.
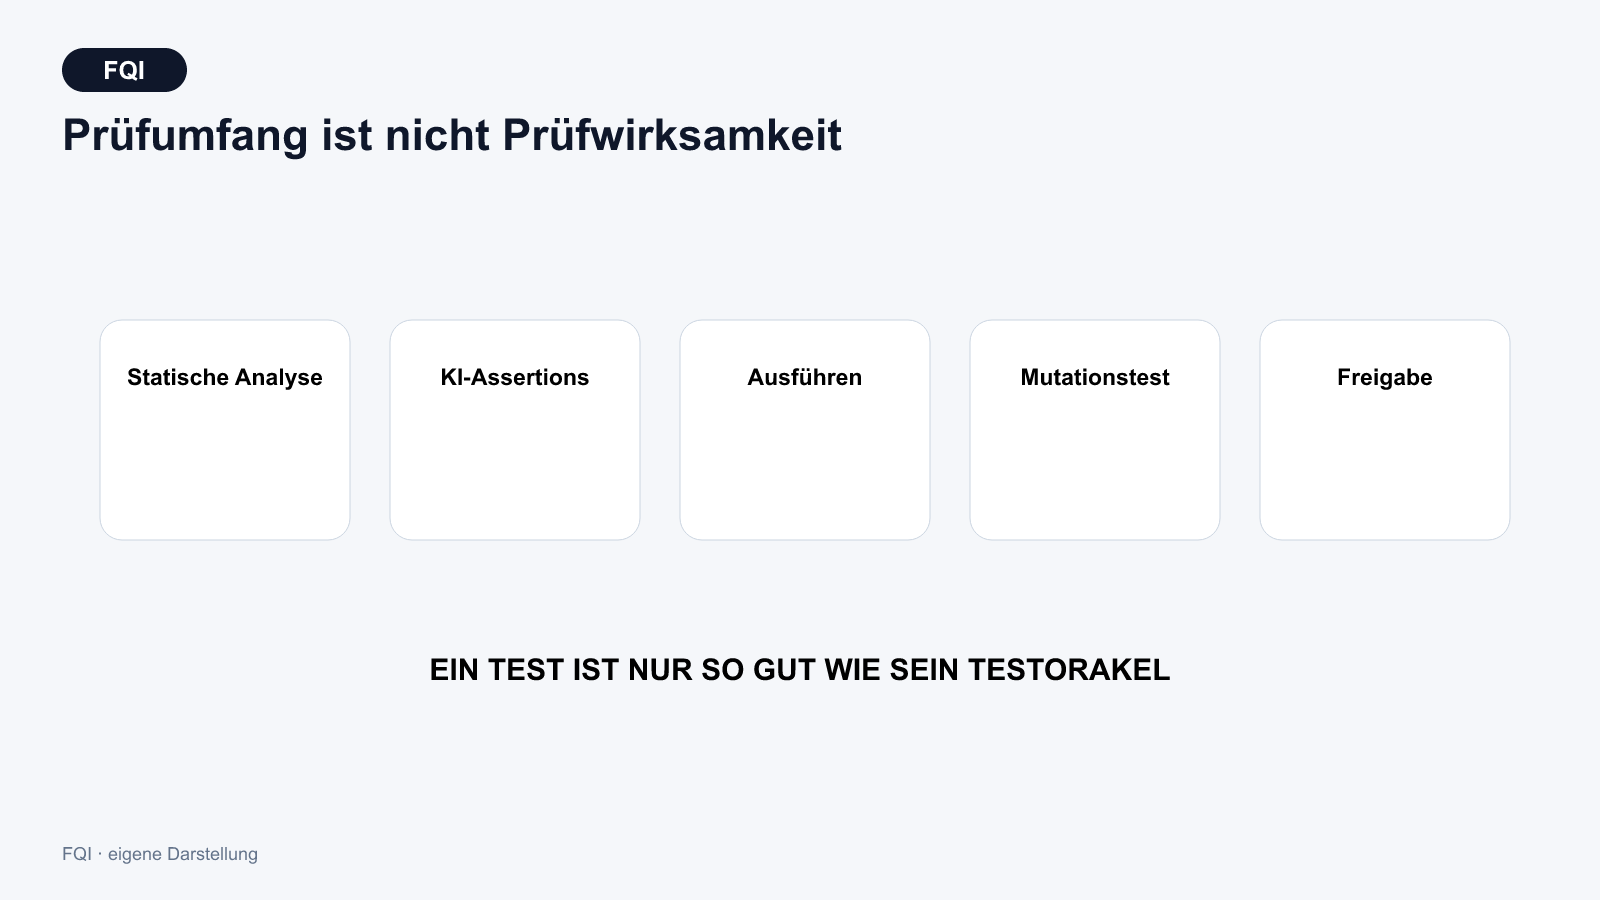
Ein konkreter Softwareanwendungsfall ist die Integration von KI in eine CI/CD-Pipeline (Continuous Integration/Continuous Delivery; kontinuierliche Integration und Bereitstellung). Das System schlägt Assertions vor, statische Analyse und Compiler prüfen die Form, Mutationstests bewerten die Fehlerentdeckung, und kritische Änderungen benötigen menschliche Freigabe. Ein zweiter, allgemeiner Anwendungsfall im Qualitätsmanagement ist ein Assistent für Prüfanweisungen. Er identifiziert aus Zeichnung und Spezifikation potenzielle Prüfmerkmale, formuliert Sollkriterien und verknüpft sie mit Fehlerfolgen aus der FMEA. Die Vorschläge werden gegen qualifizierte Referenzen geprüft; die KI entscheidet nicht allein über die Freigabe.
Der Ansatz zeigt außerdem eine sinnvolle Architekturregel: Generative KI sollte dort eingesetzt werden, wo mehrere plausible Hypothesen oder Formulierungen entstehen. Deterministische Verfahren prüfen Syntax, Typen, Ausführbarkeit und messbare Wirkung. Die Kombination ist stärker als ein rein generatives System, das seine eigenen Ergebnisse beurteilt.
Grenzen und Risiken
Erstens ist die Studie ein Preprint auf einem etablierten, aber begrenzten Java-Benchmark. Ergebnisse sind nicht automatisch auf andere Sprachen, Architekturen oder industrielle Software übertragbar.
Zweitens ist der Auswahlagent selbst ein LLM. Kandidatenerzeugung und Bewertung können daher korrelierte Fehler besitzen. Eine unabhängige fachliche oder ausführungsbasierte Prüfung bleibt notwendig.
Drittens liegen Kompilier- und Passraten deutlich unter 100 Prozent. Der Ansatz ist ein Assistenzsystem und keine autonome Freigabeinstanz.
Viertens steigt der Ressourcenverbrauch gegenüber einfacheren Verfahren. Wirtschaftlichkeit hängt von Fehlerkosten, Kritikalität und Automatisierungsgrad ab.
Fünftens kann Mutation Testing nur die eingebrachten Fehlerklassen prüfen. Nicht modellierte Anforderungen oder systemische Wechselwirkungen bleiben unentdeckt.
FQI Fazit
AssertMate liefert eine über Software hinausreichende Qualitätslektion: Ein Test ist nur so gut wie sein Testorakel. Mehr Testfälle, mehr Codeabdeckung oder mehr Agenten ersetzen keine fachlich korrekten Prüfmerkmale und Sollkriterien. Sinnvoll ist eine hybride Prüfarchitektur aus KI-generierten Kandidaten, deterministischen Checks, gezielter Fehlereinprägung und risikobasierter menschlicher Freigabe. Damit wird KI zum Werkzeug der Prüfplanung – nicht zum Ersatz für Nachweisführung.
Quellen & Transparenz
- Wang et al.: Agent-Based Test Assertion Generation via Diverse Perspective Aggregation, arXiv:2608.05822, 6. August 2026.
- Evidenzstatus: aktueller Preprint ohne abgeschlossene Peer-Review; Evaluation auf Defects4J und Fokus auf Java-Unit-Tests.
- FQI-Transfer: Die Übertragung auf allgemeine Prüfplanung, FMEA, Grenzmuster und präparierte Fehlerteile ist eine fachliche Ableitung von FQI.
- Die berichteten Kennzahlen sind benchmark- und implementierungsspezifisch; sie stellen keine allgemeine Leistungszusage für KI-gestützte Testsysteme dar.
- Dieser Beitrag wurde KI-gestützt recherchiert und redaktionell erstellt. Quellen und fachliche Transfers wurden durch KI vorgeprüft. Die menschliche Fach- und Quellenfreigabe wurde am 9. August 2026 dokumentiert; der Beitrag ist zur Veröffentlichung freigegeben.
- Freigabestatus: Begriffserklärungen und Glossar wurden am 17. August 2026 erneut menschlich geprüft und zur Veröffentlichung freigegeben. Freigabe: Johann Fischer.