
Kurzfazit
Begriffshinweis: KI – Künstliche Intelligenz; Systeme, die aus Daten Muster ableiten oder Aufgaben automatisiert unterstützen.
Eine aktuelle Untersuchung zur automatisierten Fahrzeugschadenbewertung zeigt eine typische Schwäche multimodaler KI: Ein VLM (Vision-Language Model; Bild-Sprach-Modell) erreichte eine gute semantische Klassifikation, lokalisierte kleine Schäden aber unzuverlässig. Eine vorgeschaltete Segmentierung reduzierte die berichtete Halluzinationsrate deutlich. Für die Qualitätsprüfung folgt daraus: Spezialisierte Messverfahren sollten Defekte lokalisieren; generative Modelle eignen sich eher für Kontext, Interpretation und Bericht.
FQI Takeaway
- Semantische Plausibilität ist keine räumliche Messgenauigkeit: Ein überzeugender Bericht kann auf falsch lokalisierten Bildmerkmalen beruhen.
- Hybride Architekturen sind robuster: Spezialisierte Detektion oder Segmentierung liefert Evidenz, die das generative Modell interpretieren kann.
- Die Restfehlerrate bleibt freigabekritisch: Auch ein deutlich verbessertes System benötigt eine MSA (Messsystemanalyse), Grenzmusterprüfung und menschliche Eskalation.
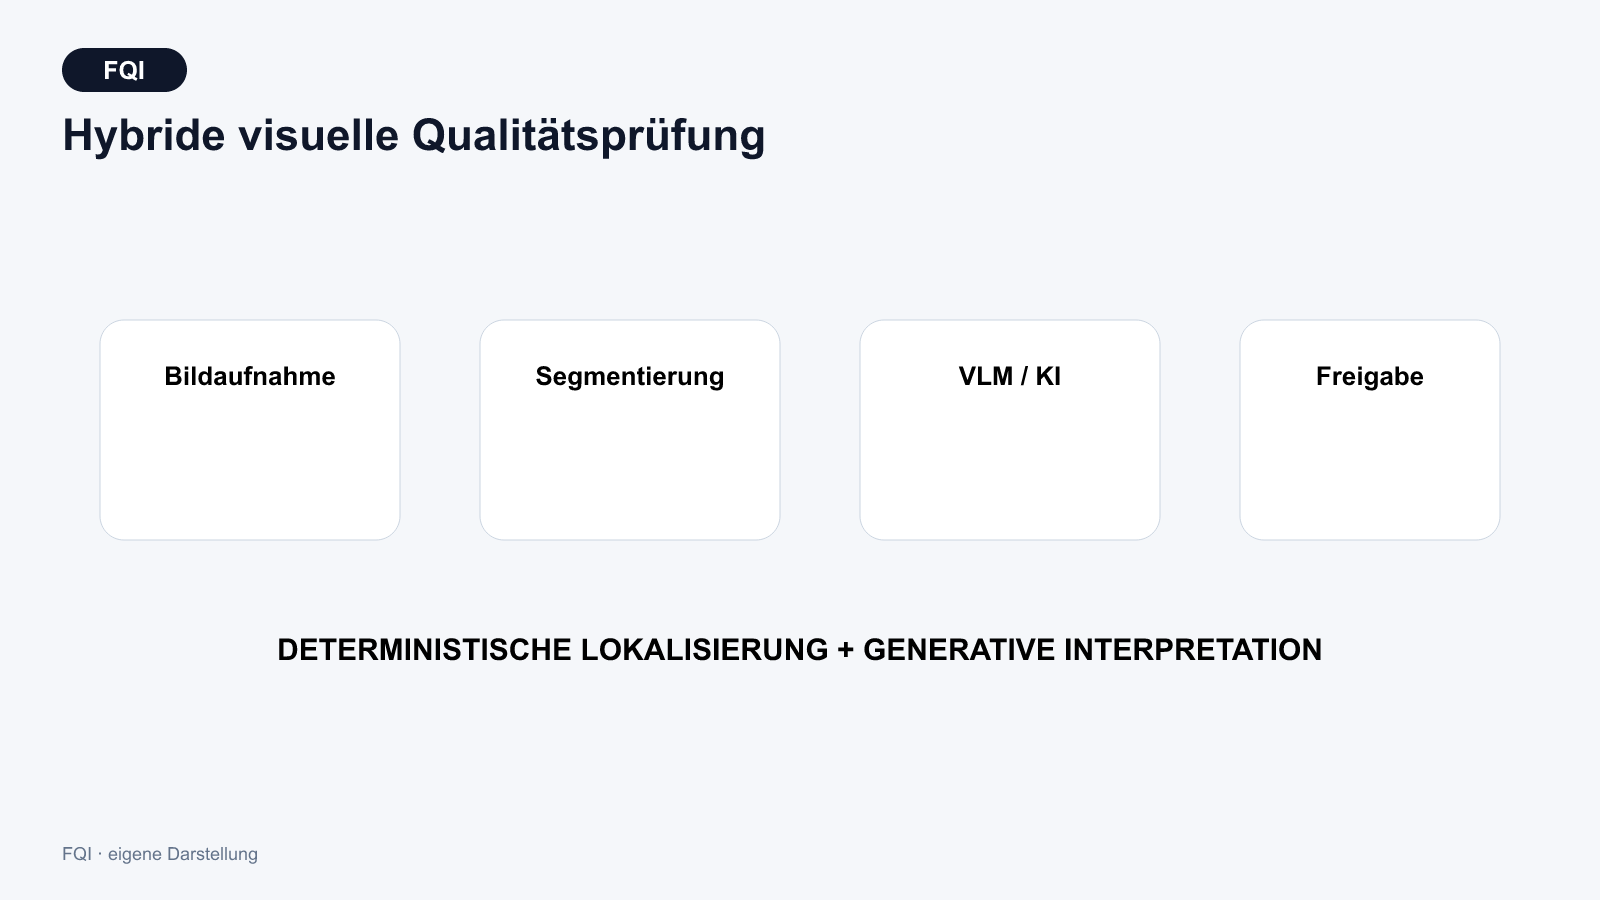
Das Prinzip auf einen Blick
Der Preprint „Grounding Agentic VLMs with Dedicated Segmentation for Fine-Grained Vehicle Damage Assessment“ wurde am 3. August 2026 veröffentlicht. Die Autoren untersuchten kleine Kratzer und feine Risse, die nur wenige Pixel belegen und leicht mit Reflexionen oder Oberflächenstrukturen verwechselt werden. Qwen-VL, ein Bild-Sprach-Modell, erreichte 87,3 Prozent semantische Klassifikationsgenauigkeit, zeigte aber Schwächen bei der räumlichen Zuordnung. Die vorgeschlagene Hybridarchitektur wurde an 100 menschlich geprüften Berichten bewertet. Die Ergebnisse sind noch nicht peer-reviewed.
Deep Dive
Multimodale Bild-Sprach-Modelle können Bilder beschreiben, Zusammenhänge erklären und Berichte formulieren. Daraus entsteht leicht der Eindruck, dass sie zugleich präzise visuelle Messsysteme seien. Die Studie zeigt, warum diese Gleichsetzung problematisch ist. Das untersuchte Modell konnte Schadenskategorien häufig korrekt benennen, halluzinierte Schäden jedoch in reflektierenden Bereichen, übersah längliche Kratzer und erzeugte bei Lokalisierungsaufgaben inkonsistente Ergebnisse.
Die Autoren trennen deshalb zwei Funktionen. Eine spezialisierte Segmentierung übernimmt die räumliche Detektion. Das Bild-Sprach-Modell verwendet diese Segmentierung anschließend als Grundlage für semantische Bewertung und Berichtserstellung. In einer kontrollierten Auswertung von 100 Berichten sank die angegebene Halluzinationsrate von 92 Prozent bei einem textbasierten und 78 Prozent bei einem rein bildbasierten Ansatz auf 31 Prozent mit Segmentierungsgrundlage. Diese Verbesserung ist erheblich, zugleich bleibt eine Halluzinationsrate von 31 Prozent für viele Freigabeentscheidungen deutlich zu hoch.
Für das Qualitätsmanagement ist die Funktionsaufteilung entscheidend. Eine visuelle Prüfung enthält mindestens drei unterschiedliche Aufgaben: Messung oder Lokalisation eines Merkmals, Klassifikation des Merkmals und Entscheidung über dessen Bedeutung. Klassische Computer Vision oder ein spezialisiertes Segmentierungsmodell kann für die erste Aufgabe besser kontrollierbar sein. Ein generatives Modell kann anschließend Kontext berücksichtigen, etwa Bauteilposition, Fehlerbeschreibung oder Prüfanweisung. Die finale Annahme- oder Sperrentscheidung sollte jedoch an definierte Kriterien und Eskalationsregeln gebunden bleiben.
Aus Sicht der MSA (Messsystemanalyse) müssen Bildaufnahme und Algorithmus gemeinsam geprüft werden. Einflussgrößen sind Beleuchtung, Kamerawinkel, Auflösung, Fokus, Oberflächenzustand, Bauteilvariante, Kontrast, Defektgröße und Bedienereinfluss. Wiederholbarkeit bedeutet, dass dasselbe Teil unter gleichen Bedingungen stabil bewertet wird. Reproduzierbarkeit betrifft unterschiedliche Anlagen, Schichten oder Aufnahmebedingungen. Für attributive Prüfungen sind Übereinstimmung mit qualifizierten Referenzurteilen, Falsch-Akzeptanz und Falsch-Rückweisung zentral. Eine hohe Gesamtgenauigkeit kann dabei seltene, aber kritische Fehler verdecken.
Die Studie liefert außerdem eine wichtige methodische Warnung: Eine verbreitete Verlustfunktion für unausgewogene Klassen führte in der untersuchten Konfiguration dazu, dass die Erkennung kleiner Schäden zusammenbrach. Das zeigt, dass etablierte Methoden des maschinellen Lernens nicht automatisch zum physikalischen Fehlerbild passen. Die Auswahl von Modellarchitektur, Verlustfunktion (Loss Function) und Trainingsdaten ist Teil der Prüfmittelentwicklung und muss über Grenzmuster abgesichert werden.
Ein industrieller Anwendungsfall wäre die Prüfung feiner Leiterbahn-, Löt- oder Gehäusefehler. Ein spezialisiertes Vision-System markiert potenzielle Defektregionen. Das multimodale Modell ordnet anschließend Bauteil, Fehlerklasse und Prüfkriterium zu und erzeugt einen nachvollziehbaren Bericht. Ein zweiter Anwendungsfall ist die Wareneingangsprüfung variantenreicher Komponenten. Hier kann ein generatives Modell Dokumente, Zeichnung und Bildbefund verbinden, sollte aber keine nicht markierte Bildstelle als Defekt behaupten dürfen.
Ein geeigneter Produktionslenkungsplan (Control Plan) würde deshalb mehrere Ebenen enthalten: qualifizierte Bildaufnahme, Detektionsschwellen, Plausibilitätsprüfung, Freigaberegel, Unsicherheitsbereich und Reaktionsplan. Fälle außerhalb des validierten Bereichs werden nicht automatisch entschieden, sondern einem Menschen vorgelegt. Die KI wird damit nicht zum alleinigen Prüfer, sondern zu einer modularen Prüfkette.
Grenzen und Risiken
Erstens handelt es sich um einen Preprint mit einer begrenzten Auswertung von 100 Berichten in einem einzelnen Anwendungsbereich. Die gemeldeten Werte sind nicht ohne eigene Validierung auf industrielle Prüfprozesse übertragbar.
Zweitens ist die Halluzinationsdefinition an die verwendeten Segmentierungsmasken und den Versuchsaufbau gebunden. Andere Fehlerdefinitionen können zu anderen Ergebnissen führen.
Drittens erzeugt eine Hybridarchitektur zusätzliche Schnittstellen und Fehlerquellen. Falsche Segmentierungen können vom Sprachmodell überzeugend weiterverarbeitet werden. Die Bindung an nachprüfbare Bildbelege (Grounding) reduziert ein Risiko, beseitigt es aber nicht.
Viertens erhöhen mehrere Modelle Latenz, Rechenkosten, Wartungsaufwand und Konfigurationsrisiko. Wirtschaftlichkeit und Prüfbedarf müssen gegen Fehlerkosten abgewogen werden.
FQI Fazit
Generative KI kann visuelle Qualitätsprüfung sinnvoll erweitern, sollte aber nicht mit einem kalibrierten Messsystem verwechselt werden. Robuste Lösungen trennen Detektion, Interpretation und Entscheidung und validieren jede Stufe einschließlich ihrer Schnittstellen. Die wichtigste Lehre aus der Studie ist nicht ein bestimmter Modellwert, sondern die Architekturentscheidung: Physische Evidenz zuerst, generative Interpretation danach, Freigabe nur innerhalb definierter Grenzen.
Quellen & Transparenz
- Hogale, Pai und Ravi: Grounding Agentic VLMs with Dedicated Segmentation for Fine-Grained Vehicle Damage Assessment, arXiv:2608.02470, 3. August 2026.
- Evidenzstatus: aktueller Preprint ohne abgeschlossene Peer-Review; kontrollierte Auswertung in der Fahrzeugschadenserkennung.
- FQI-Transfer: Die Übertragung auf MSA, attributive Prüfung, Control Plan und industrielle Bildprüfung ist eine fachliche Ableitung von FQI.
- Die berichteten Halluzinationsraten sind versuchs- und definitionsspezifisch und keine allgemeine Leistungsangabe für Bild-Sprach-Modelle.
- Dieser Beitrag wurde KI-gestützt recherchiert und redaktionell erstellt. Quellen und fachliche Transfers wurden durch KI vorgeprüft. Die menschliche Fach- und Quellenfreigabe wurde am 9. August 2026 dokumentiert; der Beitrag ist zur Veröffentlichung freigegeben.
- Freigabestatus: Begriffserklärungen und Glossar wurden am 17. August 2026 erneut menschlich geprüft und zur Veröffentlichung freigegeben. Freigabe: Johann Fischer.