
Kurzfazit
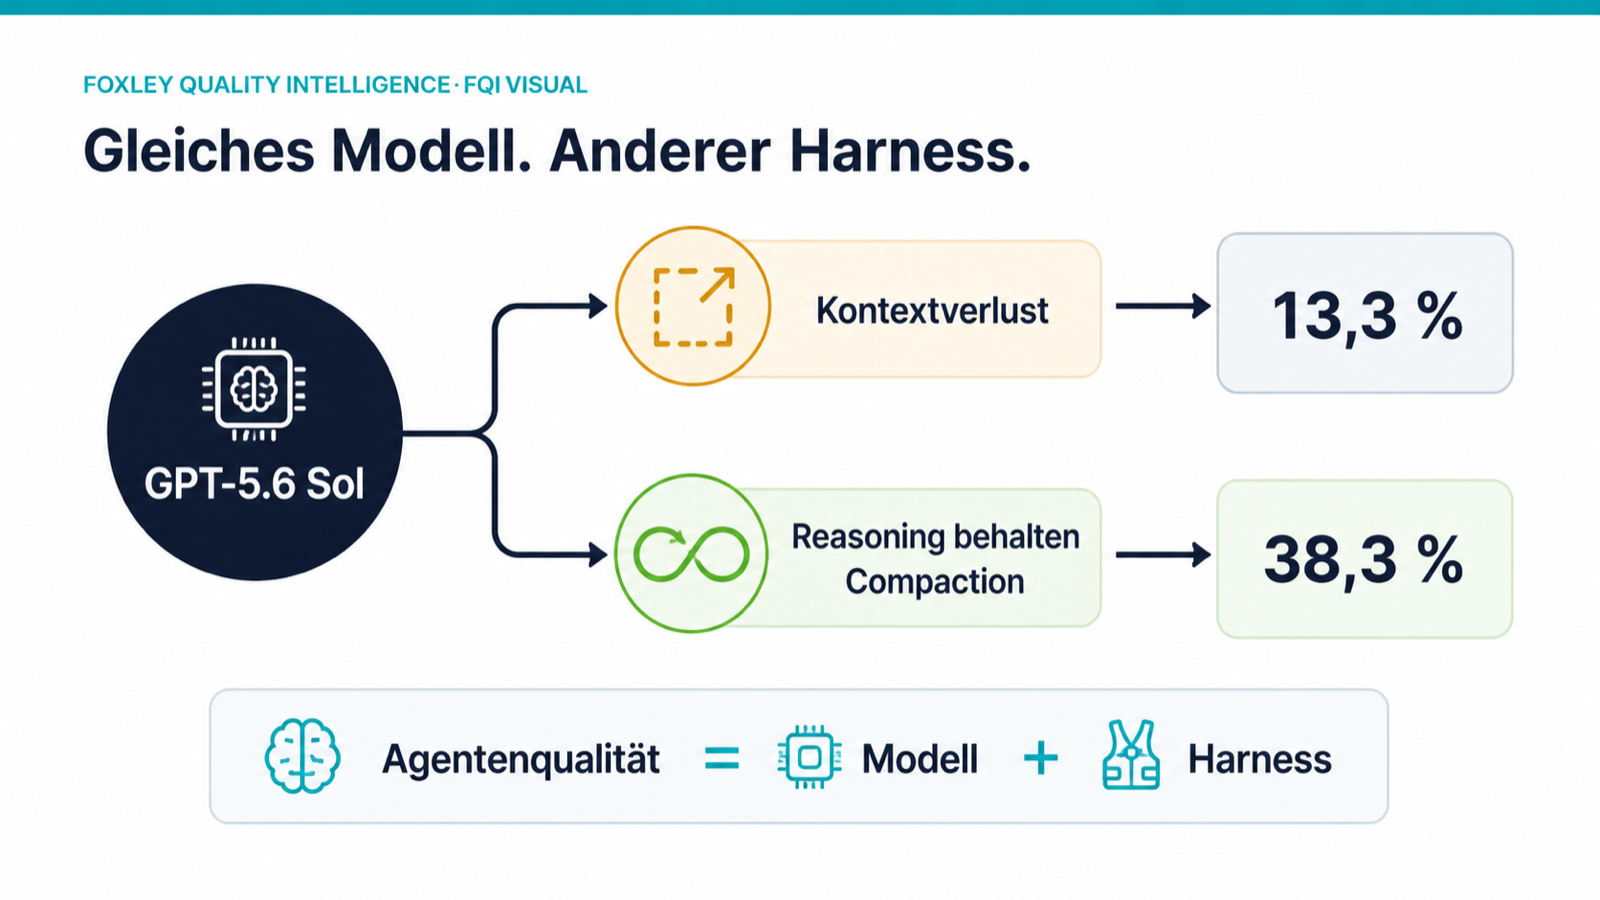
OpenAI berichtet für GPT‑5.6 Sol auf dem öffentlichen ARC‑AGI‑3-Set einen Sprung von 13,3 auf 38,3 Prozent, nachdem Reasoning über Aktionen hinweg erhalten und rollierende Kontextlöschung durch Compaction ersetzt wurde. Gleichzeitig sank die Zahl der Output-Tokens ungefähr um den Faktor sechs. Der Versuch belegt keine allgemeine Überlegenheit eines Produkts. Er zeigt aber deutlich: Bei Agenten misst ein Test nicht nur das Modell, sondern auch Gedächtnis, Kontextführung, Tools, Prompting und Orchestrierung.
FQI Takeaway
- Das Prüfobjekt ist das Gesamtsystem: Ein Modelltest allein reicht nicht, wenn der produktive Agent zusätzlich Tools, Speicher, Verdichtung, Berechtigungen und Rückkopplungen nutzt.
- Kontextverlust ist ein Fehlermodus: Abgeschnittene Historie oder verworfene Zwischenerkenntnisse können zu Wiederholung, inkonsistenten Entscheidungen und vermeidbarem Ressourcenverbrauch führen.
- Versionierte Harness-Tests sind Pflicht: Der Agenten-Harness ist die technische Steuerungsumgebung für Modell, Werkzeuge, Speicher und Kontext. Änderungen an Speicherlogik, Compaction, Prompts oder Toolschemas sollten wie Softwareänderungen mit festen Aufgaben, Grenzen und Regressionstests geprüft werden.
Das Prinzip auf einen Blick
Quellenfakten
ARC‑AGI‑3 besteht aus unbekannten 2D-Spielwelten, in denen ein Agent Regeln durch Interaktion erschließen muss. Nach OpenAIs Bericht verwarf der offizielle Harness private Reasoning-Inhalte nach jeder Aktion und entfernte bei wachsendem Verlauf ältere Aktionen über ein rollierendes Fenster. Im alternativen Responses-API-Harness blieben Reasoning-Inhalte über Aufrufe hinweg erhalten; zusätzlich verdichtete Compaction längere Verläufe, statt ältere Informationen schlicht zu löschen. Auf dem öffentlichen Set stieg der RHAE-Score dadurch von 13,3 auf 38,3 Prozent.
FQI-Ableitung
Für technische Agenten ist Kontextmanagement eine qualitätsbestimmende Prozessvariable. Wer nur das große Sprachmodell (Large Language Model, LLM) benennt, beschreibt das reale Prüfsystem unvollständig. Vergleichbar mit einer Messkette müssen Modell, Eingabedaten, Speicherzustand, Tools, Ausführungsumgebung und Auswertelogik gemeinsam spezifiziert werden.
Begriffe kurz erklärt
- KI: Künstliche Intelligenz; Systeme, die aus Daten Muster ableiten oder Aufgaben automatisiert unterstützen.
- FMEA: Fehlermöglichkeits- und Einflussanalyse; Methode zur vorbeugenden Bewertung von Risiken.
- LLM: Large Language Model; großes Sprachmodell zur Verarbeitung und Erzeugung von Text.
- Reasoning: Maschinelle Denk- und Verarbeitungsschritte; dabei werden Informationen verknüpft, um zu einer Antwort oder Entscheidung zu gelangen.
- Compaction: Gezielte Verdichtung langer Arbeitsverläufe; wichtige Informationen bleiben erhalten, während weniger relevante Details gekürzt werden.
- Prompt: Arbeitsanweisung oder Eingabe für ein sprachverarbeitendes System; sie beschreibt Aufgabe, Regeln, Kontext und erwartetes Ergebnis.
- Output-Token: Technische Verarbeitungseinheit für Text; ein Token entspricht meist einem Wort oder Wortteil, nicht zwingend einem vollständigen Wort.
- Agenten-Harness: Technische Steuerungsumgebung eines agentischen Systems; sie verbindet Modell, Arbeitsanweisungen, Werkzeuge, Speicher, Berechtigungen und Kontextverwaltung.
Deep Dive
Was der Versuch tatsächlich zeigt
Die zentrale Aussage ist enger als „Gedächtnis macht Agenten dreimal besser“. Gezeigt wurde ein großer Unterschied auf einem bestimmten öffentlichen Benchmark-Set, mit einem bestimmten Modell und zwei konkreten Harness-Konfigurationen. Der Score vergleicht Handlungseffizienz mit einem menschlichen Referenzmaß; er ist keine allgemeine Produktivitätskennzahl für Coding, Qualitätsanalyse oder Fertigung.
Trotzdem ist der Mechanismus plausibel und praktisch relevant. Wenn ein Agent nach jedem Werkzeugaufruf seine bisherigen Überlegungen verliert, muss er den Zustand erneut rekonstruieren. Wenn ältere Beobachtungen vollständig verschwinden, können frühere Randbedingungen oder erfolglose Versuche erneut auftreten. Compaction versucht dagegen, den entscheidungsrelevanten Arbeitszustand über lange Abläufe zu erhalten und irrelevante Details zu verdichten.
FQI-Praxistransfer
Ein Agent für Reklamationsanalyse könnte über viele Schritte Dokumente lesen, Klassifikationen bilden, Daten abfragen und einen Maßnahmenentwurf erzeugen. Wird der Kontext ungeprüft gekürzt, kann er eine bereits festgestellte Kundenanforderung vergessen oder widersprüchliche Ursachenhypothesen zusammenführen. In einer FMEA-Unterstützung könnten Funktionsgrenzen oder verworfene Fehlermodi verloren gehen. Das Risiko entsteht nicht im Modell allein, sondern in der Zustandsführung.
Für eine belastbare Prüfspezifikation empfiehlt sich deshalb eine Harness-Matrix: Modellversion, Promptversion, Toolversion, Berechtigungen, Kontextgrenze, Verdichtungsregel, gespeicherter Arbeitszustand und Abbruchkriterien. Ein Regressionstest sollte kurze und lange Aufgaben, Unterbrechungen, fehlerhafte Toolantworten und widersprüchliche Eingaben enthalten. Neben Ergebnisqualität gehören Tokenverbrauch, Laufzeit, Wiederholungsrate und Eskalationsverhalten in die Auswertung. Änderungen dürfen erst nach einem Vergleich gegen denselben Testbestand freigegeben werden.
Grenzen und Risiken
- Herstellerstudie: Quelle, Modell und optimierter Harness stammen von OpenAI; eine unabhängige Replikation ist im Bericht nicht enthalten.
- Benchmark-Spezifität: Ein Puzzle-Benchmark bildet weder industrielle Dokumentenarbeit noch qualitätskritische Entscheidungen direkt ab.
- Compaction kann Information verlieren: Verdichtung ist keine verlustfreie Speicherung. Falsche Zusammenfassungen können später als vermeintlicher Systemzustand wirken.
- Mehr Gedächtnis ist nicht automatisch sicherer: Persistierte sensible oder manipulierte Inhalte können Fehler und Angriffe länger im System halten.
FQI Fazit
Der ARC‑AGI‑3-Versuch liefert eine wichtige Lektion für die KI-Entwicklung: Agentenqualität entsteht aus Modell plus Harness. Für Qualitätsmanagement bedeutet das, Prüfobjekt und Änderungsumfang breiter zu definieren. Kontextverwaltung, Tools, Speicher, Verdichtung und Berechtigungen gehören in Spezifikation, Regressionstest und Freigabe. Die gemeldete Verdreifachung ist nicht übertragbar; das Prüfprinzip sehr wohl. Wer Agenten produktiv bewertet, sollte deshalb den vollständigen Arbeitsprozess testen – einschließlich langer Verläufe, Störungen, Wiederanlauf und Ressourcenverbrauch.
Quellen & Transparenz
- OpenAI: How enabling two settings tripled our scores on the ARC-AGI-3 benchmark, 29. Juli 2026.
- Die Werte 13,3 und 38,3 Prozent sowie die ungefähr sechsfache Reduktion der Output-Tokens sind Quellenfakten aus einer Herstellerstudie. Die Übertragung auf Agenten-Prüfstrategie, Änderungslenkung und Qualitätsmetriken ist eine FQI-Ableitung.
- Dieser Beitrag wurde KI-unterstützt recherchiert und redaktionell erstellt. Die Herstellerquelle, die Kennzahlen und die Trennung von Quellenfakten und FQI-Ableitung wurden am 14. August 2026 geprüft. Eine unabhängige Replikation des berichteten Versuchs ist in der Quelle nicht enthalten und bleibt eine Evidenzgrenze.
- Freigabestatus: Begriffserklärungen und Glossar wurden am 17. August 2026 erneut menschlich geprüft und zur Veröffentlichung freigegeben. Freigabe: Johann Fischer.