
Kurzfazit
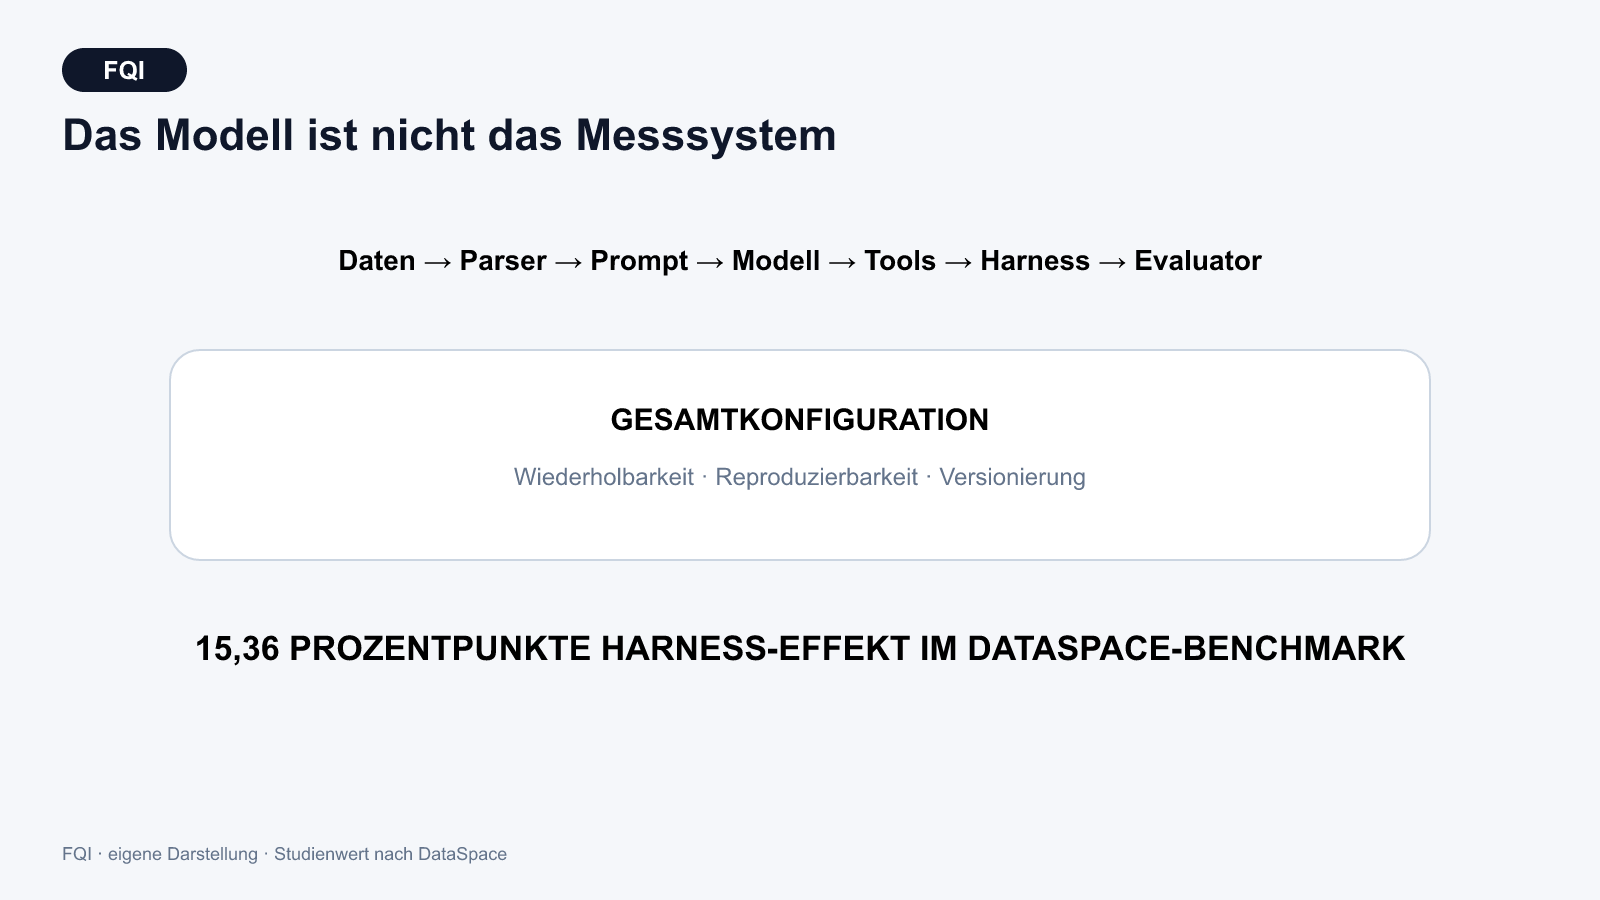
Im DataSpace-Benchmark erreichte das beste untersuchte System 66,34 Prozent Genauigkeit. Für das Qualitätsmanagement wichtiger: Bei unverändertem Basismodell erzeugte allein die Wahl des Agenten-Harness, also der Orchestrierungs- und Ausführungsumgebung, eine Spannweite von 15,36 Prozentpunkten. Ein Modellvergleich ohne kontrollierte Systemumgebung ist damit methodisch unvollständig. Promptlogik, Werkzeuge, Kontextmanagement, Parser und Ausführungsregeln sind Einflussgrößen des Gesamtprozesses.
FQI Takeaway
- Ein Benchmark bewertet eine Konfiguration, nicht nur ein Modell: Modell, Harness, Tools, Datenzugriff und Evaluator müssen gemeinsam angegeben werden.
- Der Harness ist eine MSA-Einflussgröße: MSA steht für Messsystemanalyse. Wiederholbarkeit und Reproduzierbarkeit können durch Orchestrierung stärker beeinflusst werden als erwartet.
- Modellfreigaben sind nicht übertragbar: Ein gutes Ergebnis in einer Testumgebung belegt nicht automatisch die Prozessfähigkeit im produktiven Workflow.
Das Prinzip auf einen Blick
DataSpace ist ein am 4. August 2026 eingereichter arXiv-Preprint. Der Benchmark umfasst 410 Aufgaben über heterogene Arbeitsbereiche mit insgesamt 7.439 Artefakten. Untersucht wurden sechs multimodale Frontier-Modelle und fünf Agenten-Harnesses. Die Ergebnisse sind noch nicht peer-reviewed. Der hohe Wert für das Qualitätsmanagement liegt nicht in einer Rangliste einzelner Modelle, sondern im beobachteten Einfluss der Systemumgebung auf das Ergebnis.
Begriffe kurz erklärt
- KI: Künstliche Intelligenz; Systeme, die aus Daten Muster ableiten oder Aufgaben automatisiert unterstützen.
- MSA: Messsystemanalyse; Prüfung, ob ein Messsystem für die vorgesehene Entscheidung geeignet ist.
- DOE: Design of Experiments; statistische Versuchsplanung zur Ermittlung von Einflussgrößen und Wechselwirkungen.
- DMAIC: Define, Measure, Analyze, Improve and Control; strukturierter Verbesserungszyklus aus Six Sigma.
- 8D: Acht-Disziplinen-Problemlösungsmethode; D1 bis D8 strukturieren Team, Problem, Ursache, Maßnahmen und Abschluss.
- Prompt: Arbeitsanweisung oder Eingabe für ein KI-System; sie beschreibt Aufgabe, Regeln, Kontext und erwartetes Ergebnis.
- Agenten-Harness: Technische Steuerungsumgebung eines agentischen Systems; sie verbindet Modell, Arbeitsanweisungen, Werkzeuge, Speicher, Berechtigungen und Kontextverwaltung.
Deep Dive
In Diskussionen über KI-Qualität wird häufig so gesprochen, als sei das Basismodell die alleinige Ursache des Outputs. Bei agentischen Anwendungen ist das fachlich nicht haltbar. Ein Agenten-Harness entscheidet unter anderem, welche Informationen in den Kontext gelangen, wie Dateien gelesen werden, welche Werkzeuge verfügbar sind, wann Zwischenergebnisse gespeichert werden, wie Fehler behandelt werden und wie viele Versuche zulässig sind. Zwei Systeme mit demselben Modell können deshalb unterschiedliche Aufgabenpfade, Datenstände und Ergebnisse erzeugen.
DataSpace bildet komplexe Analyseaufgaben mit unterschiedlichen Dateiformaten ab. Der Benchmark enthält unter anderem strukturierte Daten, Dokumente und multimodale Artefakte. Nach Angaben der Autoren erreichte das beste System 66,34 Prozent Genauigkeit. Bei festgehaltenem Basismodell führte die Wahl des Harness zu einer Ergebnisdifferenz von 15,36 Prozentpunkten. Zusätzlich sanken die Ergebnisse bei multimodaler Evidenzintegration und Datenverknüpfungen. Diese Zahlen belegen nicht, dass jeder Harness-Effekt in der Industrie gleich groß ist. Sie zeigen aber, dass die Orchestrierung eine eigenständige, messbare Einflussgröße ist.
Aus Sicht der MSA (Messsystemanalyse) lässt sich das KI-System als erweiterte Messkette betrachten. Das Modell entspricht dabei nicht dem gesamten Messgerät. Weitere Komponenten sind Datenkonnektoren, Dokumentparser, Informationsabruf (Retrieval), Promptvorlagen, Toolauswahl, Speicherlogik, Evaluator und Laufzeitumgebung. Eine Änderung an nur einer Komponente kann das Ergebnis verschieben. Deshalb reicht die Angabe „Modell X“ für einen reproduzierbaren Qualitätsnachweis nicht aus.
Ein MSA-inspiriertes Versuchsdesign könnte dieselben Aufgaben mehrfach über verschiedene Konfigurationen ausführen. Dabei werden Modell, Harness, Datenversion und Lauf zufällig oder systematisch variiert. Analysiert werden Wiederholbarkeit innerhalb derselben Konfiguration und Reproduzierbarkeit zwischen Harnesses, Modellen oder Umgebungen. Bei kategorialen Ergebnissen sind Übereinstimmungsmaße, Fehlerklassen und Konfusionsmatrizen geeigneter als eine klassische Kennzahl zur Wiederhol- und Reproduzierbarkeit. Für kontinuierliche Scores können Varianzkomponenten untersucht werden. Entscheidend ist, die Einflussgrößen experimentell zu trennen.
Die Verbindung zu DOE (Design of Experiments; statistische Versuchsplanung) und Six Sigma ist ebenfalls stark. Ein faktorieller Versuchsplan kann Haupt- und Wechselwirkungseffekte von Modell, Promptstrategie, Retrievaltiefe, Toolset und Dateityp sichtbar machen. Das verhindert, dass ein Ergebnis vorschnell dem „besseren Modell“ zugeschrieben wird. In der Improve-Phase eines DMAIC-Projekts – DMAIC steht für Define, Measure, Analyze, Improve and Control, auf Deutsch Definieren, Messen, Analysieren, Verbessern und Steuern – wäre der Harness damit ein steuerbarer Prozessfaktor. In der Control-Phase müssten Konfiguration, Versionen und Grenzwerte überwacht werden.
Zwei Anwendungen sind unmittelbar relevant. Bei einer KI zur Analyse von Prüfberichten sollte ein Modellvergleich nur unter identischen Parsern, Suchregeln und Bewertungsdaten erfolgen. Danach muss die vollständige Zielkonfiguration nochmals durchgängig (End-to-End) validiert werden. Bei einem agentischen 8D-Assistenten (Acht-Disziplinen-Problemlösungsmethode) sollte nicht nur die Textqualität bewertet werden, sondern auch, ob Quellen korrekt geladen, Fakten nicht zwischen Fällen vermischt und fehlende Informationen zuverlässig eskaliert werden. Ein Modell kann sprachlich überlegen sein und dennoch im schlechteren Harness weniger zuverlässige Arbeitsergebnisse liefern.
Grenzen und Risiken
Erstens ist DataSpace ein Preprint und bildet eine spezifische Aufgabenklasse ab. Die Ergebnisse dürfen nicht als allgemeingültige Effektgröße für alle Agentensysteme interpretiert werden.
Zweitens ist die MSA-Analogie nützlich, aber nicht vollständig. KI-Ausgaben sind häufig semantisch und stochastisch; klassische Annahmen über lineare Messfehler oder stabile Referenzwerte gelten nicht immer.
Drittens kann eine starke Standardisierung des Harness Innovation bremsen. Änderungen sollten nicht verboten, sondern kontrolliert, versioniert und erneut validiert werden.
Viertens bleibt die Qualität des Referenzurteils kritisch. Ein deterministischer Evaluator ist reproduzierbar, kann aber systematisch falsche Zielkriterien abbilden. Auch das „Masterteil“ des Benchmarks muss qualifiziert sein.
FQI Fazit
Die zentrale Lehre lautet: KI-Qualität ist eine Systemeigenschaft. Wer nur Modellnamen vergleicht, vermischt Produkt-, Mess- und Prozessfaktoren. Für belastbare Entscheidungen müssen Modell und Harness als vollständige Konfiguration behandelt werden. MSA, DOE, Konfigurationsmanagement und End-to-End-Validierung liefern dafür ein bereits bekanntes methodisches Fundament. Das Qualitätsmanagement muss diese Methoden nicht neu erfinden, sondern konsequent auf die digitale Mess- und Entscheidungskette erweitern.
Quellen & Transparenz
- Li et al.: DataSpace: Benchmarking Data Agents for Verifiable Analytics over Heterogeneous Workspaces, arXiv:2608.03451, eingereicht am 4. August 2026.
- Evidenzstatus: aktueller Preprint ohne abgeschlossene Peer-Review; Ergebnisse gelten für den untersuchten Benchmark und die getesteten Konfigurationen.
- FQI-Transfer: Die Einordnung des Harness als MSA- und DOE-Einflussgröße ist eine fachliche Ableitung von FQI.
- Die Begriffe Wiederholbarkeit und Reproduzierbarkeit werden analog verwendet; für semantische KI-Ausgaben sind angepasste Messgrößen erforderlich.
- Dieser Beitrag wurde KI-gestützt recherchiert und redaktionell erstellt. Quellen und fachliche Transfers wurden durch KI vorgeprüft. Die menschliche Fach- und Quellenfreigabe wurde am 9. August 2026 dokumentiert; der Beitrag ist zur Veröffentlichung freigegeben.
- Freigabestatus: Begriffserklärungen und Glossar wurden am 17. August 2026 erneut menschlich geprüft und zur Veröffentlichung freigegeben. Freigabe: Johann Fischer.