
Kurzfazit
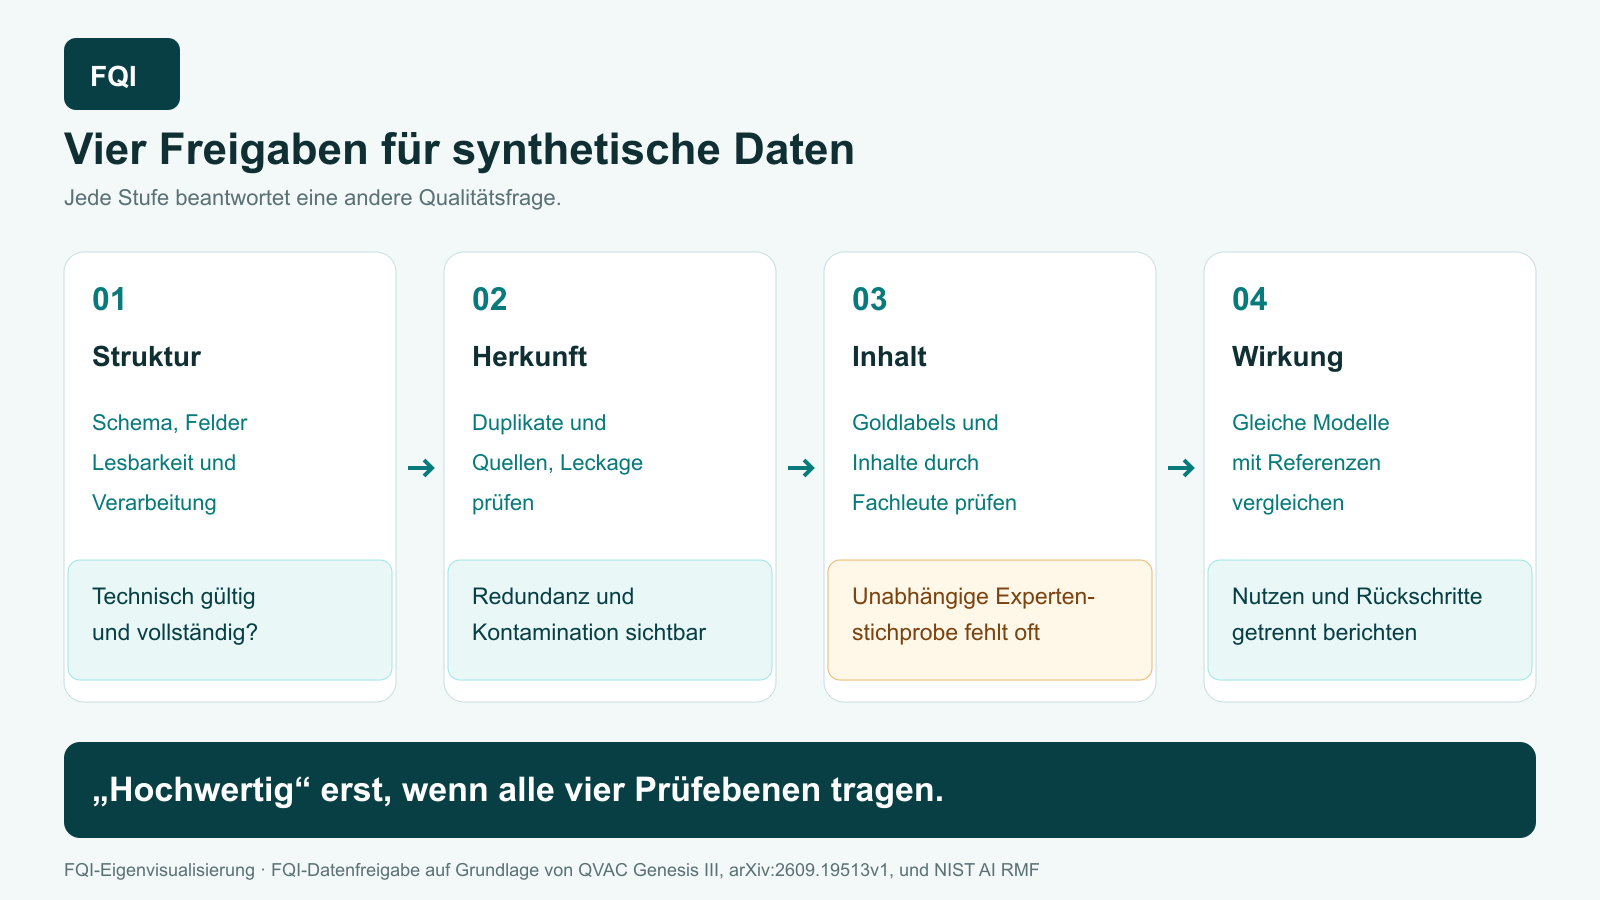
Ein synthetischer Datensatz ist nicht schon deshalb hochwertig, weil er groß, formal sauber oder benchmarkwirksam ist. QVAC Genesis III macht mehrere Prüfschichten sichtbar: 191,43 Milliarden technische Textverarbeitungseinheiten, sogenannte Token, werden auf Redundanz, Benchmark-Kontamination und Wirkung im kontrollierten Training untersucht. Das ist wesentlich belastbarer als eine reine Mengenangabe. Zugleich benennt der Preprint eine zentrale Lücke: Eine fachmenschliche Prüfung von Richtigkeit, pädagogischem Nutzen und Halluzinationen der erzeugten Erklärungen bleibt künftige Arbeit. Für FQI ergibt sich ein Freigabemodell aus vier getrennten Qualitätsstufen.
FQI Takeaway
- Prüfschichten nicht vermischen: Struktur, Herkunft, fachliche Richtigkeit und Modellwirkung beantworten unterschiedliche Qualitätsfragen.
- Wirksamkeit kontrolliert vergleichen: Datensätze müssen bei vergleichbarem Modell, Tokenbudget und Trainingsablauf gegen geeignete Referenzen antreten.
- Goldlabels unabhängig prüfen: Wenn dasselbe Lehrermodell Aufgabe, richtige Option und Erklärung erzeugt, kann ein konsistenter Fehler die Pipeline unentdeckt durchlaufen.
Das Prinzip auf einen Blick
QVAC Genesis III ist ein synthetischer Datensatz für Naturwissenschaft, Technik, Ingenieurwesen und Mathematik (STEM). Ungefähr 500.000 gefilterte Webpassagen dienen als Ausgangspunkt. Das Sprachmodell QwQ-32B erzeugt daraus Multiple-Choice-Fragen, vier Optionen und ein Goldlabel für die angeblich richtige Antwort. Ein kleines Schülermodell beantwortet die Fragen. Fehler werden in Korrekturerklärungen umgewandelt; richtige Antworten führen zu Begründungen für jede einzelne Option.
Begriffe kurz erklärt
- Synthetische Daten: Künstlich erzeugte Trainingsinhalte statt direkt beobachteter oder menschlich verfasster Beispiele.
- Goldlabel: Als richtig gesetzte Referenzantwort, gegen die andere Antworten bewertet werden.
- Deduplizierung: Suche nach gleichen oder sehr ähnlichen Dokumenten, damit Wiederholungen Ergebnisse nicht verzerren.
- Kontamination: Unerwünschte Überschneidung von Trainingsdaten mit späteren Testaufgaben.
- Ablation: Kontrollierter Vergleich, bei dem einzelne Datenbestandteile getrennt trainiert und bewertet werden.
- Token: Technische Textverarbeitungseinheit, meist ein Wort oder Wortteil.
- NIST: National Institute of Standards and Technology; US-Institut für Standards und Technologie.
- KI: Künstliche Intelligenz; Systeme, die aus Daten Muster ableiten oder Aufgaben automatisiert unterstützen.
Deep Dive
Der fertige Korpus umfasst 191,43 Milliarden Token in rund 159,6 Millionen Dokumenten aus 19 STEM-Gebieten und drei Schwierigkeitsstufen. Ein Token ist eine Verarbeitungseinheit des Sprachmodells, oft ein Wortteil. Der Option-Level-Teil enthält Erklärungen zu richtigen und falschen Auswahlmöglichkeiten. Der Failure-Analysis-Teil nutzt falsche oder nicht eindeutig auslesbare Schülerantworten als Anlass für Korrekturtexte. Beide Teile werden in vier Darstellungsstilen erzeugt.
Die Redundanzprüfung nutzt MinHash-Signaturen über alle Dokumente. Von 47.927 markierten Paaren bleiben 1.729 eindeutige Near-Duplicates, weniger als 0,002 Prozent des Korpus. Für Kontamination werden Überschneidungen mit Testdatensätzen gesucht und anschließend verifiziert. Die Autoren berichten 17 kontaminierte Dokumente insgesamt, keine Überschneidung mit dem GSM8K-Testsatz und drei Treffer unter 56.168 MMLU-Testaufgaben. Diese Prüfung reduziert ein Risiko, beweist aber nicht die fachliche Richtigkeit der übrigen Inhalte.
Für die Wirkungsprüfung trainieren die Autoren Modelle mit 1,7 Milliarden Parametern von zufälliger Initialisierung. Modellarchitektur und Hyperparameter bleiben in den Hauptvergleichen gleich. Gegen einen tokenbudgetnahen Cosmopedia-v2-Lauf verbessert der kombinierte QVAC-Korpus die Genauigkeit um 28,57 Prozentpunkte auf ARC-Easy, 21,35 auf ARC-Challenge und 15,03 auf MMLU STEM. Gegen das veröffentlichte Cosmo-1B ist der Vorsprung kleiner und bei der Rate eindeutig auslesbarer Antworten sogar 0,45 Punkte niedriger. Die Quelle prüft den Option-Level-Teil außerdem mit drei anderen Modellfamilien.
Für Qualitätsmanagement entsteht daraus ein vierstufiges Gate. Stufe eins kontrolliert Schema, Lesbarkeit, Pflichtfelder und maschinelle Verarbeitbarkeit. Stufe zwei prüft Herkunft, Redundanz und mögliche Testleckage. Stufe drei untersucht fachliche Richtigkeit über geschichtete Stichproben, mehrere unabhängige Fachbewertungen und dokumentierte Konfliktlösung. Stufe vier misst die Wirkung in kontrollierten Trainingsvergleichen und beobachtet neben Mittelwerten auch Aufgabenklassen und Verschlechterungen.
QVAC deckt die Stufen eins, zwei und vier vergleichsweise gut ab. Stufe drei bleibt offen. Das National Institute of Standards and Technology (NIST), die US-Behörde für Messwesen und Standards, fordert passend dazu dokumentierte Dateneignung, Konstruktvalidität, vergleichbare Testbedingungen und die Bewertung der verwendeten Prüfverfahren. Das ist ein organisatorischer Rahmen, kein Nachweis für den konkreten FQI-Prozess.
Grenzen und Risiken
Der Preprint ist nicht begutachtet. Lehrer, Generator und Korrekturautor sind in wichtigen Schritten dasselbe QwQ-32B-Modell; interne Konsistenz kann daher gemeinsame Fehler verdecken. Der Parser ermittelt nur die gewählte Option und urteilt nicht über fachliche Richtigkeit. Die Benchmarks liegen thematisch nahe am Korpus und decken reale Bildung oder industrielle Nutzung nicht vollständig ab. Auch die berichteten Zugewinne gelten nur für die untersuchten Modelle, Budgets und Trainingskonfigurationen. Größe und Rechenaufwand sind nicht auf jedes Unternehmen übertragbar.
FQI Fazit
QVAC zeigt, wie ein Datenrelease mehr liefern kann als Umfang und Marketing: dokumentierte Struktur, Deduplizierung, Kontaminationsscan und kontrollierte Wirkung bilden eine nachvollziehbare Prüfkette. Die offen benannte Lücke ist ebenso wichtig. Datenqualität braucht zusätzlich eine unabhängige semantische Abnahme. Erst wenn technische Gültigkeit, Herkunft, fachliche Richtigkeit und nachgewiesene Wirkung gemeinsam bestanden sind, trägt die Bezeichnung „hochwertiger Trainingsdatensatz“ eine belastbare Freigabeentscheidung.
Quellen & Transparenz
- QVAC Research Team: QVAC Genesis III: A Large-Scale, High-Quality Open Synthetic STEM Corpus for Efficient Language Model Pre-Training, arXiv:2609.19513v1, insbesondere Abschnitte 3–6.
- National Institute of Standards and Technology: AI Risk Management Framework Core, insbesondere MAP 2.3 sowie MEASURE 2.3, 2.5 und 2.13.
Redaktioneller Hinweis: Korpusgröße, Prüfungen und Benchmarkwerte sind berichtete Quellenbefunde. Das Vier-Stufen-Gate und die unabhängige semantische Abnahme sind FQI-Einordnung. Unterstützt durch Künstliche Intelligenz (KI) erstellt und gegen die angegebenen Quellen geprüft.