
Kurzfazit
Eine künstliche Intelligenz, kurz KI, kann auffällige Bauteile finden, ohne dass ihre vollständige Erkennungsleistung nachgewiesen ist. Entscheidend ist, welche Teile anschließend eine unabhängige Prüfung erhalten. Werden ausschließlich KI-Alarme untersucht, bleiben übersehene Fehler außerhalb der Auswertung. Eine aktuelle Ford-Fallstudie macht diese Nachweislücke sichtbar. Für das Qualitätsmanagement folgt daraus ein konkreter Auftrag: Der Prüfplan muss auch nicht alarmierte Teile einschließen und bestätigte Defekte von fachlichem Verdacht trennen. Ein guter Alarm ist zunächst ein Prüfhinweis, keine Freigabegrundlage.
FQI Takeaway
- Auch ohne Alarm prüfen: Eine geplante Referenzstichprobe aus unauffälligen Teilen macht übersehene Fehler überhaupt beobachtbar.
- Bezugsmenge nennen: Trefferanteil unter Alarmen und Erkennungsrate aller Fehler beantworten verschiedene Fragen.
- Unklare Befunde erhalten: Fehlender Reklamationseingang oder ein auffälliger Signalverlauf ersetzen keinen gesicherten Qualitätsbefund.
Das Prinzip auf einen Blick
Die untersuchte KI-Anwendung ist unüberwachtes maschinelles Lernen: Aus Prüfstandssignalen wird eine kompakte Beschreibung des üblichen Getriebeverhaltens gelernt. Abweichungen dienen zur Auswahl zusätzlicher Prüffälle. Der KI-Bezug liegt damit in der datenbasierten Anomalieerkennung, nicht in einer bloßen Automatisierung der Messung.
Für die Bewertung zählen zwei unterschiedliche Kennzahlen. Precision beschreibt, welcher Anteil der Alarme nach der festgelegten Referenzbewertung tatsächlich positiv ist. Recall beschreibt, welcher Anteil aller tatsächlich positiven Fälle erkannt wurde. Die offizielle scikit-learn-Dokumentation definiert Recall mit einem Nenner, der auch übersehene positive Fälle enthält. Ohne deren Erfassung fehlt die Grundlage für eine Aussage über die gesamte Erkennungsleistung.
Begriffe kurz erklärt
- Referenzbewertung: Vorab festgelegtes, fachlich begründetes Verfahren, mit dem ein Prüfergebnis verglichen wird.
- Precision: Trefferanteil unter den vom System gemeldeten Auffälligkeiten.
- Recall: Anteil erkannter Fälle an allen tatsächlich positiven Fällen der betrachteten Grundgesamtheit.
Deep Dive
Bisheh und Mitautoren untersuchen Getriebedaten aus der Endprüfung. Für einen Teilvergleich bewerten Fachleute nur die vom neuen Verfahren alarmierten Einheiten. Tabelle 9 umfasst 16 Fälle: zehn positive und sechs negative Referenzbewertungen, sämtlich vom neuen Modell als auffällig eingestuft. Der dort genannte Recall von 1,00 gilt für diese ausgewählte Menge. Er belegt nicht, dass außerhalb dieser Menge keine Fehler übersehen wurden.
Die folgende Konsequenz ist FQI-Einordnung: Wenn das zu prüfende Modell selbst bestimmt, welche Fälle ein Referenzurteil erhalten, kann es seine blinden Flecken aus der Auswertung ausschließen. Das ist auch dann relevant, wenn jeder einzelne Alarm sorgfältig geprüft wird. Die Qualität der Referenzprüfung und die Auswahl ihrer Prüffälle sind zwei getrennte Anforderungen.
Ein betrieblicher Pilot beginnt deshalb mit einem klaren Zweck. Soll das Modell lediglich zusätzliche Untersuchungen priorisieren oder später Teile automatisch freigeben? Für die Priorisierung können nützliche zusätzliche Hinweise bereits einen Wert haben. Für eine Freigabe muss der Nachweis auch das Risiko fehlerhafter, nicht alarmierter Teile erfassen. Die Messsystemanalyse betrachtet entsprechend die gesamte Entscheidungskette einschließlich Fallauswahl und Referenzverfahren.
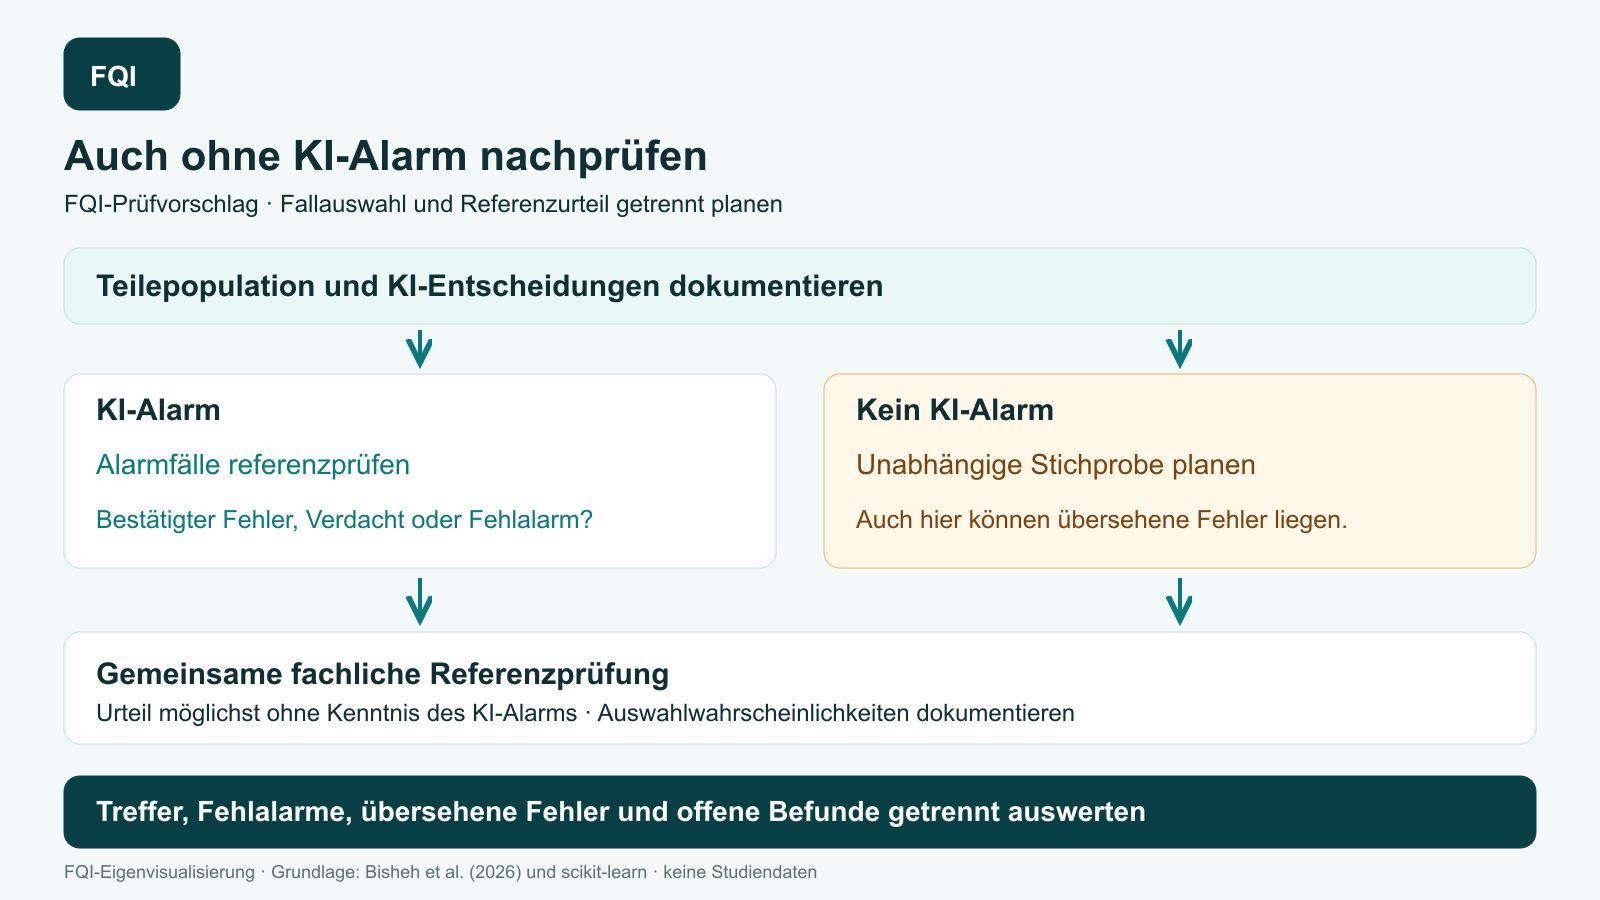
Vor dem Pilot werden Teilepopulation, Zeitraum, Varianten und Fehlerdefinition festgelegt. Jeder Fall erhält eine durchgängige Kennung. Das Protokoll hält die ursprüngliche Modellentscheidung, den Signalstand und den späteren Referenzbefund getrennt fest. Ein auffälliger Verlauf kann prüfwürdig sein, ohne bereits einen bestätigten Defekt darzustellen. Diese Befundarten dürfen nicht nachträglich zu einem einzigen Gut-Schlecht-Label verschmelzen.
Die Referenzprüfung umfasst anschließend zwei vorab geplante Gruppen: alarmierte Teile und eine zufällige oder nachvollziehbar geschichtete Auswahl nicht alarmierter Teile. Solche Gruppen können beispielsweise unterschiedliche Produktvarianten oder Fertigungszeiträume abbilden. Fachprüfer sollten die KI-Einstufung möglichst erst nach ihrem eigenen Urteil sehen. Das reduziert die Gefahr, dass ein Alarm die Referenzbewertung selbst beeinflusst.
Wer die Gruppen unterschiedlich stark beprobt, darf ihre Ergebnisse nicht einfach zusammenzählen und als Produktionsquote ausgeben. Auswahlwahrscheinlichkeiten und Bezugsgrößen bleiben dokumentiert; eine fachkundige statistische Auswertung berücksichtigt die Stichprobenplanung. Fallzahl und notwendige Prüftiefe folgen den Fehlerfolgen und der erwarteten Seltenheit kritischer Defekte. Dafür lässt sich aus diesem Preprint keine allgemeine Mindestzahl ableiten.
Auch der Vergleich zweier Modelle braucht dieselbe, unabhängig ausgewählte Referenzmenge. Enthält sie nur Alarme des neuen Modells, kann das ältere Verfahren Treffer außerhalb dieser Auswahl nicht zeigen. Der Abschlussbericht trennt deshalb zusätzliche bestätigte Funde, Fehlalarme, übersehene Defekte und ungeklärte Fälle. Änderungen an Vorverarbeitung oder Alarmschwelle lösen eine erneute Prüfung aus.
Grenzen und Risiken
Die Arbeit ist ein Preprint mit Ford-Mitautorschaft und vertraulichen Produktionsdaten; eine unabhängige Reproduktion liegt hier nicht vor. Expertenurteile und Garantieinformationen bilden unterschiedliche Referenzen. Zudem stimmen einzelne Jahres- und Fallangaben im Manuskript nicht vollständig überein. Eine angekündigte spätere Rückkopplung aus Garantiefällen ist kein bereits belegter Langzeitnachweis.
Der FQI-Prüfplan ist eine methodische Ableitung, keine in der Studie validierte Lösung. Auch unabhängige Stichproben können seltene Fehler verfehlen. Fehlende Nachweise rechtfertigen weder eine behauptete Nullfehlerrate noch das pauschale Urteil, das Modell sei unbrauchbar.
FQI Fazit
Der erste praktische Schritt ist eine einfache Kontrollfrage im Abnahmeprotokoll: Können in unserer Auswertung überhaupt Fehler auftauchen, für die die KI keinen Alarm ausgelöst hat? Wenn die Antwort nein lautet, bleibt die vollständige Erkennungsleistung offen. Eine zusätzliche, nachvollziehbar ausgewählte Referenzstichprobe schafft dafür eine bessere Grundlage. FQI empfiehlt, Alarmnutzen und Freigabeeignung getrennt zu bewerten und jede Kennzahl mit ihrer Bezugsmenge zu berichten. So wird aus einer vielversprechenden Anomalieerkennung ein überprüfbarer Qualitätsprozess.
Quellen & Transparenz
-
Bisheh et al.: Ford-Fallstudie zur Getriebe-Endprüfung, Version 1, insbesondere Abschnitte 3, 5.8 und 5.9 sowie Tabellen 8–11. Manuskriptdatum 4. Oktober, Feed-Ankündigung 7. Oktober 2026.
-
scikit-learn: Recall-Definition und Precision-Definition, unabhängige methodische Grundlage, keine Bestätigung der Ford-Ergebnisse.
-
arXiv-Publikationseintrag, dieselbe Studie, keine weitere unabhängige Quelle.
Originalvolltext und Kennzahlendefinitionen gelesen. Befunde, Nachweisgrenzen und FQI-Prüfplan sind getrennt dargestellt. KI-unterstützt erstellt und redaktionell freigegeben.