
Kurzfazit
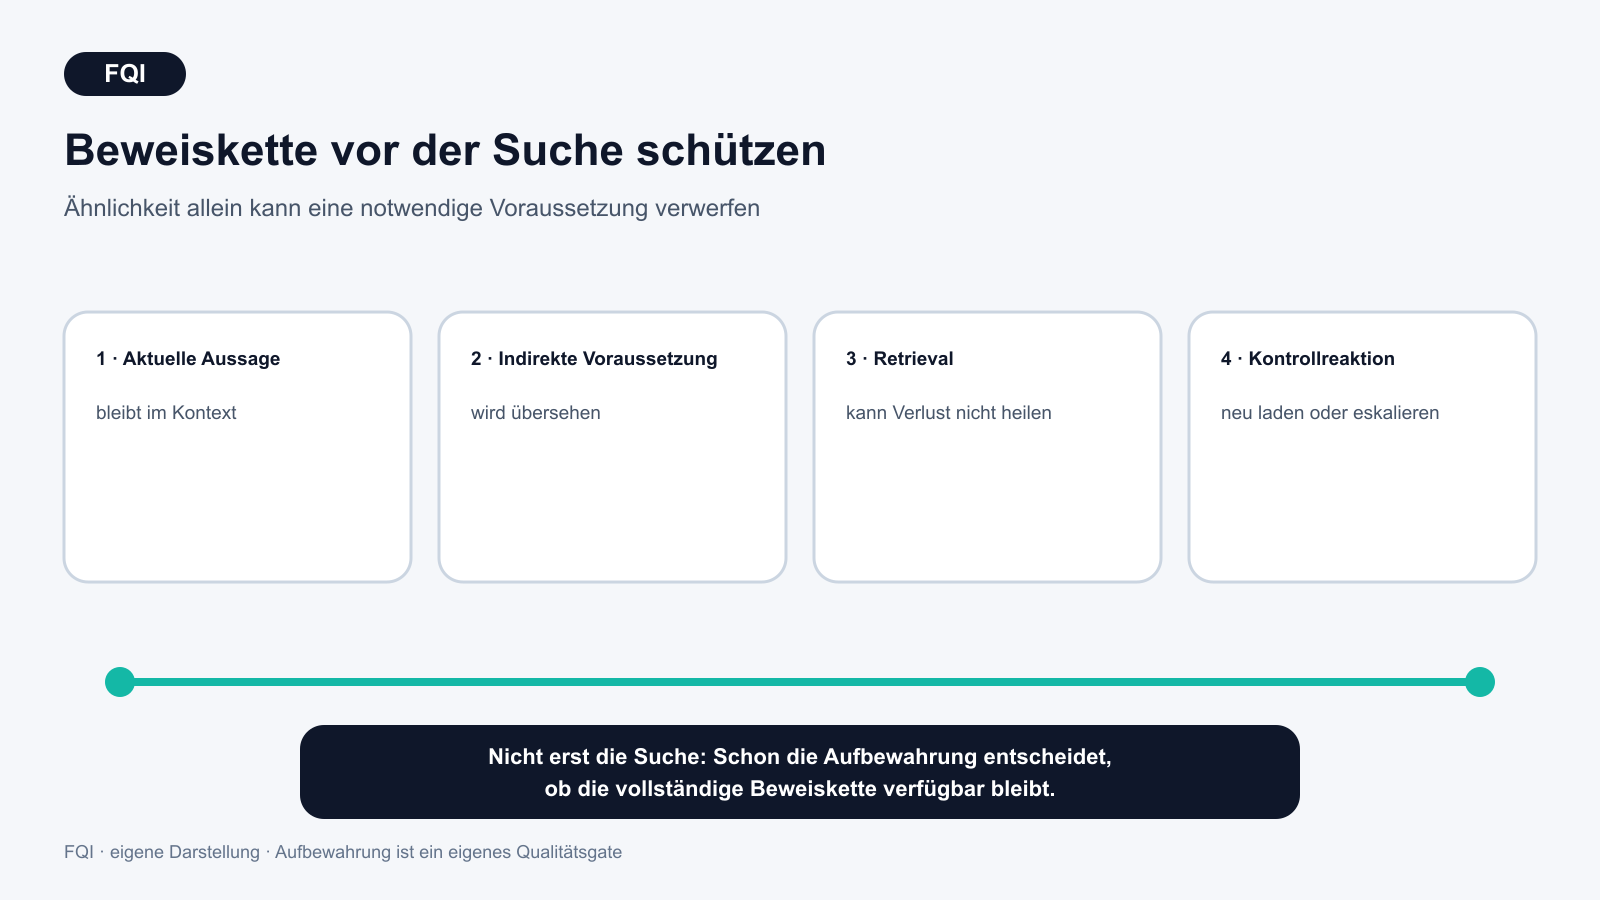
Künstliche Intelligenz (KI) kann in einem Agentensystem zu einer falschen Entscheidung führen, obwohl die Suche technisch korrekt arbeitet: Die notwendige Vorinformation wurde schon vorher aus dem begrenzten Gedächtnis entfernt. Eine aktuelle Studie isoliert diesen Fehler und testet eine einfache Gegenmaßnahme, die Abhängigkeiten zwischen Informationsblöcken berücksichtigt. Für das Qualitätsmanagement folgt daraus ein eigener Kontrollpunkt: Vor jeder Suche muss geprüft werden, ob die vollständige Beweis- und Entscheidungskette überhaupt noch verfügbar ist.
FQI Takeaway
- Speichern kommt vor Suchen: Ein Retriever kann keine Voraussetzung finden, die das System bereits verworfen hat.
- Abhängigkeiten brauchen Schutz: Relevante Regeln, Versionen und Freigabebedingungen müssen zusammen mit der aktuellen Aussage erhalten bleiben.
- Vollständigkeit wird zur Kennzahl: Nicht nur Antworttreffer, sondern auch das Überleben der gesamten Beweiskette muss getestet werden.
Das Prinzip auf einen Blick
Agentische KI-Systeme arbeiten häufig mit einem begrenzten Kontextbudget. Sie müssen deshalb entscheiden, welche älteren Informationen erhalten bleiben. Übliche Verfahren bevorzugen aktuelle oder sprachlich ähnliche Inhalte. Genau dabei kann eine indirekte Voraussetzung verloren gehen: Sie klingt nicht nach der aktuellen Frage, ist aber logisch notwendig, um eine spätere Aussage richtig anzuwenden.
Die Studie nennt ihre Gegenmaßnahme Dependency-aware Semantic Garbage Collection (DSGC). Das Verfahren schützt unmittelbare Voraussetzungen eines relevanten Informationsblocks über eine bekannte Abhängigkeitskante. Es verändert also nicht die spätere Suche, sondern die vorgelagerte Aufbewahrungsentscheidung.
Begriffe kurz erklärt
- LLM: Large Language Model; großes Sprachmodell zur Verarbeitung und Erzeugung von Text.
- KI: Künstliche Intelligenz; Systeme, die aus Daten Muster ableiten oder Aufgaben automatisiert unterstützen.
- Retrieval: gezieltes Wiederfinden bereits gespeicherter Informationen für eine aktuelle Aufgabe.
- DSGC: graphbasierte Regel, die direkt abhängige Voraussetzungen beim Aussortieren von Kontext mitberücksichtigt.
- CAPA: Corrective and Preventive Action; gelenkter Prozess für Korrektur- und Vorbeugemaßnahmen.
- 8D: Acht-Disziplinen-Problemlösungsmethode; D1 bis D8 strukturieren Problem, Ursache, Maßnahmen und Abschluss.
- NIST: US-amerikanisches National Institute of Standards and Technology.
Deep Dive
Der Preprint verwendet vier synthetische Szenarien mit jeweils 20 Informationsblöcken. Zwei Kontrollfälle lassen sich über Textähnlichkeit lösen; zwei Zielfälle enthalten eine dreistufige Voraussetzungskette. Getestet werden 15 feste Zufallsstarts, zwei Encoder und drei Aufbewahrungsregeln. Bei den Zielfällen stieg die vollständige Kettenerhaltung mit DSGC beim lexikalischen Encoder von 0,03 auf 0,90 und beim Satz-Encoder von 0,23 auf 1,00. Die Kontrollfälle blieben bei 1,00.
Diese Werte belegen keine Produktionsreife. Sie zeigen aber einen klar abgegrenzten Fehler: Eine aktuelle Regel kann im Kontext bleiben, während die ältere Bedingung verschwindet, die ihre Anwendung überhaupt erlaubt. Mehr Suchqualität repariert diesen Verlust nicht.
Für einen 8D- oder CAPA-Assistenten lässt sich das in eine prüfbare Prozesslogik übersetzen. Eine vorgeschlagene Maßnahme könnte etwa von der betroffenen Prozessversion, einem freigegebenen Control Plan und einer gültigen Prüfmittelentscheidung abhängen. Wird nur die Maßnahme gespeichert, nicht aber ihre Voraussetzungen, erscheint sie später plausibel und ist dennoch falsch zugeordnet.
Praktisch beginnt die Absicherung mit einer Abhängigkeitskarte für entscheidungsrelevante Informationen. Dokumentversion, Gültigkeitsbereich, Quelle und Freigabestatus werden nicht nur als Metadaten gespeichert, sondern mit den Aussagen verknüpft, die davon abhängen. Beim Verdichten des Kontexts erhält die gesamte Kette einen Schutzwert. Testfälle erzeugen anschließend gezielt Konkurrenz durch ähnlich klingende, aber fachlich irrelevante Inhalte.
Als Prozesskennzahlen eignen sich der Anteil vollständig erhaltener Entscheidungsketten, fehlende Voraussetzungen pro Antwort und korrekt ausgelöste Abbrüche. Fehlt eine notwendige Bedingung, sollte der Agent nicht improvisieren, sondern die Quelle erneut laden oder an einen Menschen eskalieren. Diese Logik ergänzt die NIST-Funktionen Map, Measure und Manage: Systemgrenzen dokumentieren, Fehler messbar machen und eine kontrollierte Reaktion festlegen.
Grenzen und Risiken
Die Studie stammt von einem einzelnen Autor, ist ein Preprint und wurde nur für einen nicht-archivalen Workshop angenommen. Der Benchmark nutzt kleine synthetische Vorlagen und vorgegebene Abhängigkeitskanten. In realen Qualitätsdaten müssten solche Beziehungen erst zuverlässig erkannt und gepflegt werden. Falsche Kanten können irrelevante Inhalte schützen und dadurch echte Belege verdrängen. Zudem fällt die lexikalische Variante bei 50 statt 20 Blöcken deutlich ab; ein Ein-Schritt-Verfahren schützt mehrstufige Ketten nicht vollständig. End-to-End-Entscheidungen mit einem realen Sprachmodell wurden nicht untersucht.
FQI Fazit
Der Beitrag erweitert die Qualitätsprüfung von KI-Agenten um eine oft übersehene Stufe. Vor Retrieval, Antwortbewertung und menschlicher Freigabe steht die Frage, ob alle notwendigen Voraussetzungen erhalten geblieben sind. Für FQI ist das ein starker Transfer zu Dokumentenlenkung, Traceability und Wirksamkeitsprüfung: Eine überzeugende Antwort reicht nicht. Das System muss nachweisen können, dass die zugrunde liegende Entscheidungskette vollständig, gültig und kontrolliert abrufbar war.
Quellen & Transparenz
- Song, Minkyu: When Retrieval Fails Before It Begins: Structurally Indirect Prerequisite Eviction as a Retention Failure in Agentic Memory, arXiv:2608.20400v1, 5. Juli 2026.
- Der öffentliche Reproduktionscode enthält Protokolle, Ergebnisse, Robustheitsläufe und Kalibrierungshistorie.
- NIST: Artificial Intelligence Risk Management Framework 1.0, NIST AI 100-1. Der FQI-Transfer zu 8D, CAPA, Dokumentenlenkung und vollständigen Entscheidungsketten ist eine redaktionelle Einordnung.
- Evidenzstatus: synthetischer, reproduzierbarer Benchmark ohne industrielle Feldvalidierung. Dieser Beitrag wurde KI-gestützt erstellt. Quellen, Zahlen, Übersetzung und FQI-Einordnung wurden am 24. August 2026 von Johann Fischer geprüft und zur Veröffentlichung freigegeben.