
Kurzfazit
Künstliche Intelligenz (KI) kann Agenten befähigen, Informationen abzurufen, Werkzeuge zu bedienen und selbstständig zu handeln. Öffentliche Vorfälle mit solchen Agenten können mehr leisten als warnende Einzelfälle: Richtig strukturiert zeigen sie, welche Fehlermuster ein Prüfprogramm noch nicht abdeckt. Das neue Agent Incident Registry (AIR) verbindet 487 veröffentlichte Ereignisse mit Quellen, stabilen Kennungen und nachvollziehbaren Kategorien. Seine wichtigste Aussage ist methodisch, nicht statistisch: Vorfallanteile sind keine Ausfallraten. Für FQI entsteht daraus ein kontrollierter Regelkreis von Vorfallaufnahme über Korrektur- und Vorbeugungsmaßnahmen (Corrective and Preventive Action, CAPA) bis zu Test, Evaluation, Verification and Validation (TEVV; strukturierter Eignungsnachweis) und Wirksamkeitsprüfung.
FQI Takeaway
- Vorfälle werden zu Prüfanforderungen: Oberfläche, Auslöser, Berechtigung und Wirkung lassen sich gegen vorhandene Testfälle spiegeln.
- Beleg und Bewertung bleiben getrennt: Eine Quellenstelle belegt, dass ein Ereignis berichtet wurde; sie beweist weder Häufigkeit noch jede Ursachenzuschreibung.
- CAPA endet nicht beim Fix: Jede relevante Lücke braucht einen reproduzierbaren Test, einen Verantwortlichen und eine dokumentierte Rückführung in Freigabe und Überwachung.
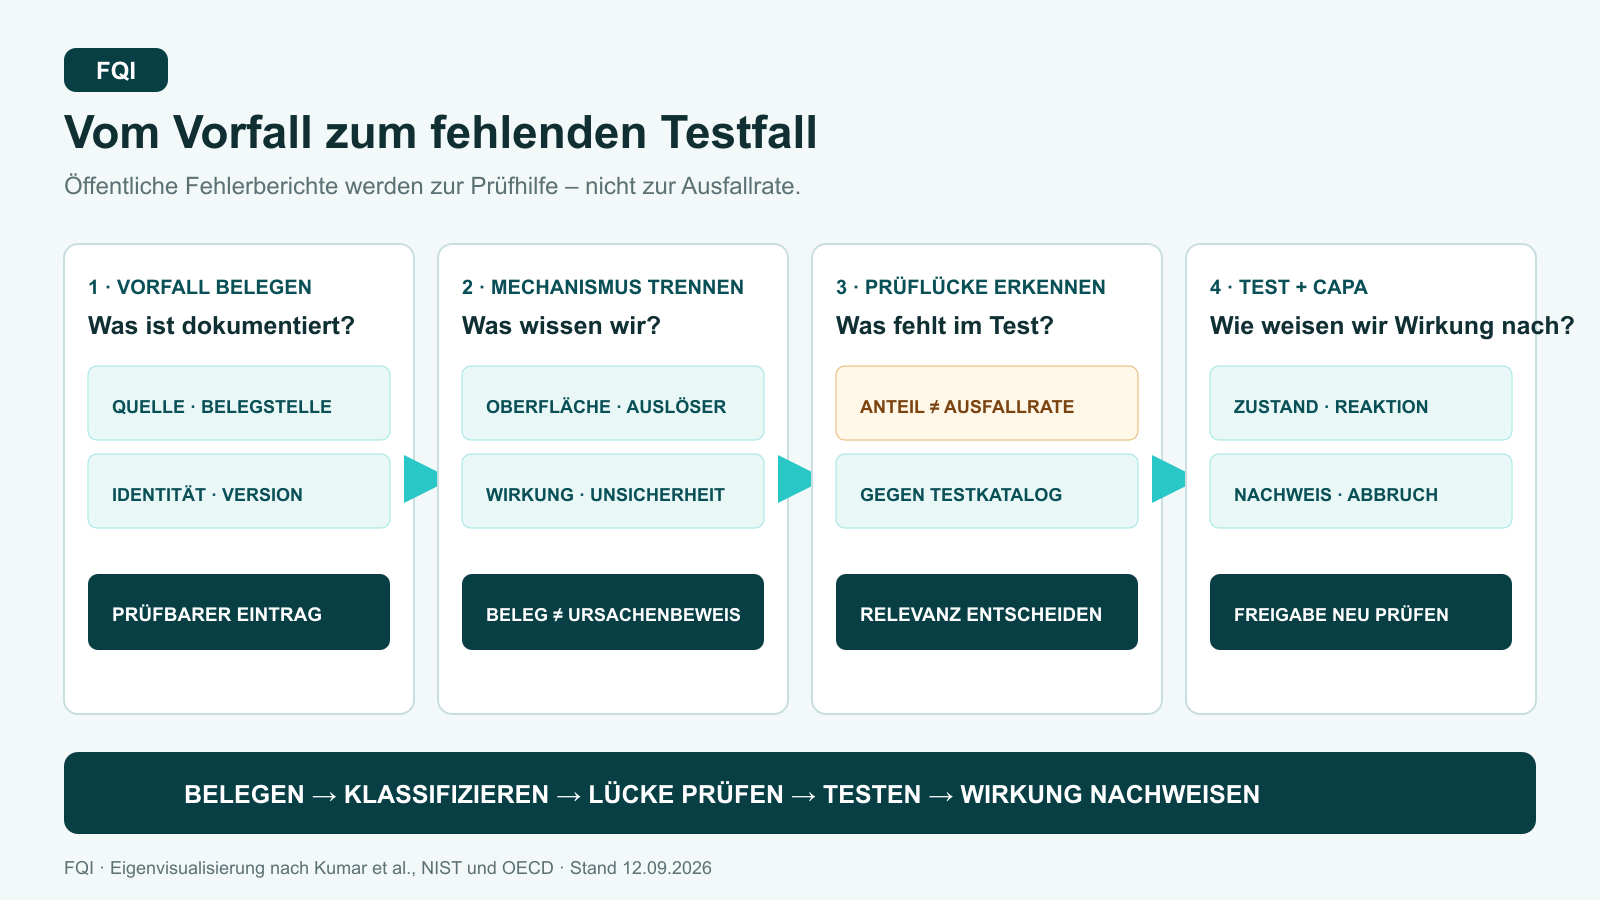
Das Prinzip auf einen Blick
AIR sammelt Berichte über Systeme, die Werkzeuge verwenden, Informationen abrufen, delegierte Rechte ausüben oder autonom handeln. Aus 602 Kandidaten wurden nach dokumentierter Zusammenführung 487 Registereinträge. Jeder angenommene Eintrag benötigt mindestens eine abrufbare Quelle und eine kurze Belegstelle. Das Schema trennt unter anderem tatsächliche Schäden von demonstrierten Fähigkeiten, die Rolle des Agenten vom Offenlegungsweg sowie bekannte Angaben von ausdrücklich fehlenden Daten.
Begriffe kurz erklärt
- KI: Künstliche Intelligenz; hier ein Softwaresystem, das Aufgaben plant und über Werkzeuge oder Schnittstellen Handlungen ausführen kann.
- CAPA: Corrective and Preventive Action; systematische Korrektur- und Vorbeugungsmaßnahmen.
- TEVV: Test, Evaluation, Verification and Validation; strukturierter Nachweis, dass ein KI-System für seinen Einsatzzweck geeignet ist.
- NIST: National Institute of Standards and Technology; US-Institut für Standards und Technologie.
Der vollständige Katalog umfasst 487 Einträge. Davon betreffen 380 Fälle, in denen der Agent selbst handelte. Die engere Hauptpopulation enthält 336 generative Systeme mit Agentenhandlung; 81 Einträge sind dort als realisierter Schaden markiert. Diese 24 Prozent beschreiben ausschließlich die Zusammensetzung der veröffentlichten Fälle. Ohne Zahl aller betriebenen Systeme und Ausführungen lässt sich daraus weder ein Einsatzrisiko noch eine Anbieterbewertung ableiten.
Deep Dive
Gerade diese Begrenzung macht das Register für Qualitätsarbeit nützlich. Es ist kein Prozessfähigkeitsnachweis, sondern eine strukturierte Quelle für Fehlermuster. AIR erfasst unter anderem Einsatzoberfläche, Auslöser, kausale Rolle, Folgen, vorhandene Schutzmaßnahmen und Behebungsinformationen. Ein Prüfteam kann diese Merkmale mit seinem Testkatalog verknüpfen: Welche Oberflächen sind abgedeckt? Welche Berechtigungs- und Zustandswechsel werden variiert? Gibt es Fälle ohne Angreifer, etwa zerstörerische Befehle, unbeabsichtigte Veröffentlichungen oder fehlerhafte Wiederanläufe?
Der Vergleich mit dem Sicherheitsbenchmark InjecAgent macht eine mögliche Lücke sichtbar. Dessen 1.054 Fälle decken in der gewählten Zuordnung drei von zwölf Einsatzoberflächen ab und verwenden immer einen angreifergesteuerten Auslöser. AIR enthält dagegen 92 Sicherheitsfehler ohne gegnerischen Trigger, davon 87 mit realisierter Wirkung. Daraus folgt nicht, dass InjecAgent schlecht ist. Es zeigt, welche zusätzlichen Tests für Arbeitslast, Speicherzustand, Berechtigungen, Wiederanlauf und sichere Reaktion nötig sein könnten.
Ein praktikabler FQI-Ablauf beginnt mit einem versionierten Vorfallsdatensatz. Mehrfachberichte desselben Ereignisses werden zusammengeführt; Unsicherheit und fehlende Angaben bleiben sichtbar. Danach ordnet ein interdisziplinäres Team relevante Mechanismen den eigenen Prozessen, Werkzeugen und Risiken zu. Nur eine belegte Lücke wird in einen Testfall übersetzt: definierter Ausgangszustand, auslösende Veränderung, erwartete sichere Reaktion, beobachtbarer Nachweis und Abbruchkriterium. Der neue Test läuft gegen die tatsächlich eingesetzte Systemkonfiguration und wird bei Modell-, Werkzeug-, Rechte- oder Infrastrukturänderungen erneut bewertet.
Das US-Institut für Standards NIST (National Institute of Standards and Technology) fordert dokumentierte Prüfverfahren, regelmäßiges Nachverfolgen neuer Risiken sowie die Rückführung von Felddaten in Messung und Risikobehandlung. Der OECD-Rahmen ergänzt 29 gemeinsame Berichtskriterien, die über Rechtsräume und Branchen hinweg angepasst werden können. Beide Quellen stützen die organisatorische Einordnung unabhängig vom Registeranbieter: Vorfälle sollen vergleichbar erfasst und in Überwachung, Risikobehandlung und kontinuierliche Verbesserung zurückgeführt werden.
Grenzen und Risiken
AIR ist ein Preprint und keine repräsentative Stichprobe. Öffentliche Meldungen hängen von Medieninteresse, Offenlegungskultur, Sprache und Produktverbreitung ab. 30 Einträge verwenden Sekundärberichte; eine Belegstelle bestätigt zudem nur, dass eine Quelle eine Behauptung aufstellt. Ein Kurator entschied die erste Klassifikation, ein zweiter Mensch prüfte die sichtbaren Labels, sodass keine unabhängige Übereinstimmungskennzahl vorliegt. Für 390 von 487 Einträgen fehlen ausreichende Angaben zur Wirksamkeit von Kontrollen. Die Autoren legen offen, dass ihr Arbeitgeber Agentensicherheitsprodukte verkauft. Registerzahlen taugen daher weder als Lieferantenranking noch als Risikopriorität; diese bleibt organisationsspezifisch.
FQI Fazit
Ein Vorfallregister wird dann qualitätsfähig, wenn es nicht als Rangliste, sondern als Lern- und Prüfquelle eingesetzt wird. AIR trennt Quelle, Ereignis, Klassifikation und Unsicherheit ungewöhnlich konsequent. Der stärkste Transfer liegt in der Rückkopplung: Ein belegter Vorfall deckt eine mögliche Prüflücke auf, die als reproduzierbarer Test in Freigabe und Überwachung eingeht. So wird aus öffentlicher Fehlererfahrung kein Alarmismus, sondern ein auditierbarer CAPA- und TEVV-Regelkreis.
Quellen & Transparenz
- Kumar et al.: The Agent Incident Registry: Toward Preventing Repeated AI Agent Failures, arXiv:2609.11030v1, eingereicht am 10. September 2026.
- National Institute of Standards and Technology: AI Risk Management Framework Core, insbesondere MEASURE 3.1 und 4.1 bis 4.3 sowie MANAGE 4.1 bis 4.3.
- OECD: Towards a common reporting framework for AI incidents, 28. Februar 2025.
- Evidenzstatus: Registeraufbau, Fallzahlen, Benchmarkvergleich und Grenzen stammen aus dem vollständig geprüften Preprint. Die Übertragung auf CAPA, Prüfabdeckung, Änderungsprüfung und Freigaben ist FQI-Praxistransfer, gestützt durch NIST und OECD.
- Dieser Entwurf wurde mit künstlicher Intelligenz unterstützt; menschliche Fach-, Quellen- und Veröffentlichungsfreigabe liegen noch nicht vor.